探针 9|AI 根本没记住你,它只是每次重读一遍
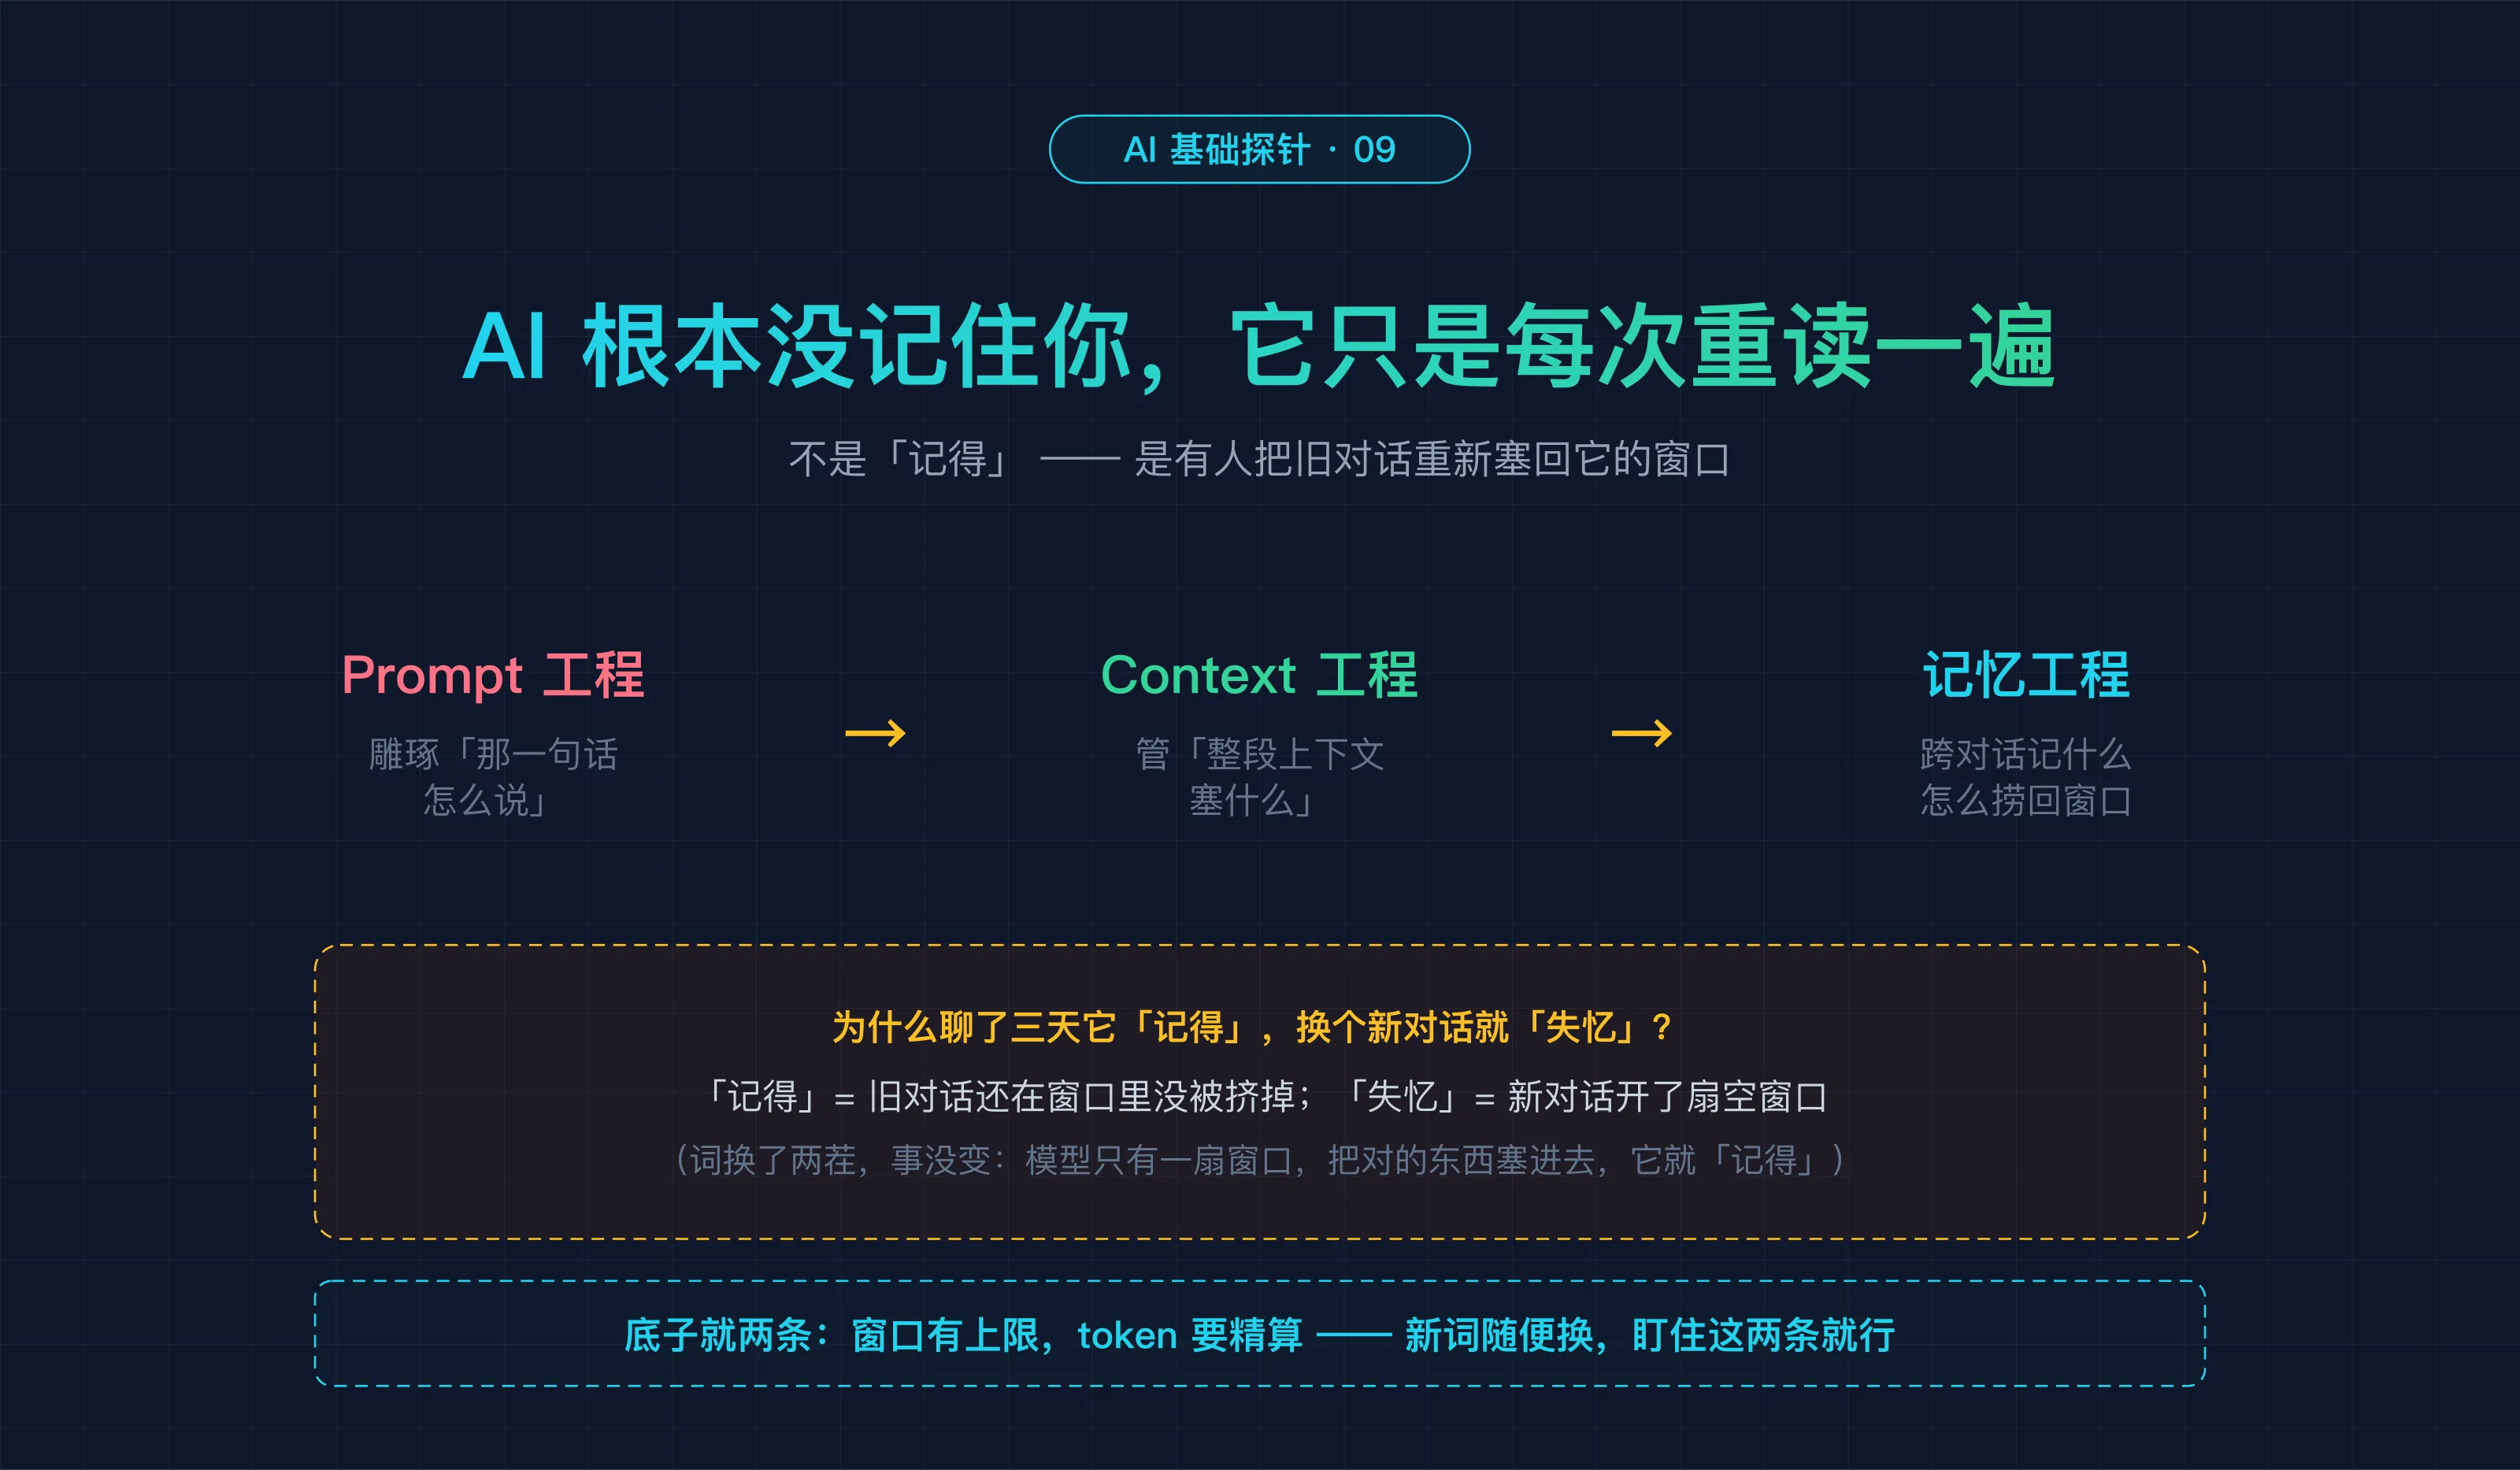
它「记得」你,是因为窗口里还有你
你跟 AI 聊了三天。你的项目、你的偏好、你踩过的坑,它都接得住;第二天接着聊,它还记得你昨天说了什么。
可你开个新对话试试。
它两眼一抹黑,连你是谁都不知道,之前聊的全没了。同一款模型,昨天还贴心,今天失忆。
它到底是怎么「记住」的?这篇就挖这个。
模型没有记忆,只有一扇窗口
先说结论:模型压根没有记忆器官。
前面讲过(探针 5),它每次回答,能看到的只有一扇固定大小的窗口。所谓「还记得」,只是因为旧对话还留在窗口里、没被新内容挤出去;所谓「失忆」,只是因为新对话开了一扇空窗口。
那那些「跨对话也记得」的产品是怎么做到的?是有人提前把值得记的东西存到窗口外面,下次开新对话,再把相关的捞回来、塞进窗口。
所以它不是记得你——它只是每次都重新读了一遍你。 你以为它在回忆,其实是有人把资料又递到了它眼前。
管这扇窗口的活,名字已经换了两茬
「往窗口里塞什么、什么顺序、什么时机、怎么省」,这门活的名字,两年换了两次。
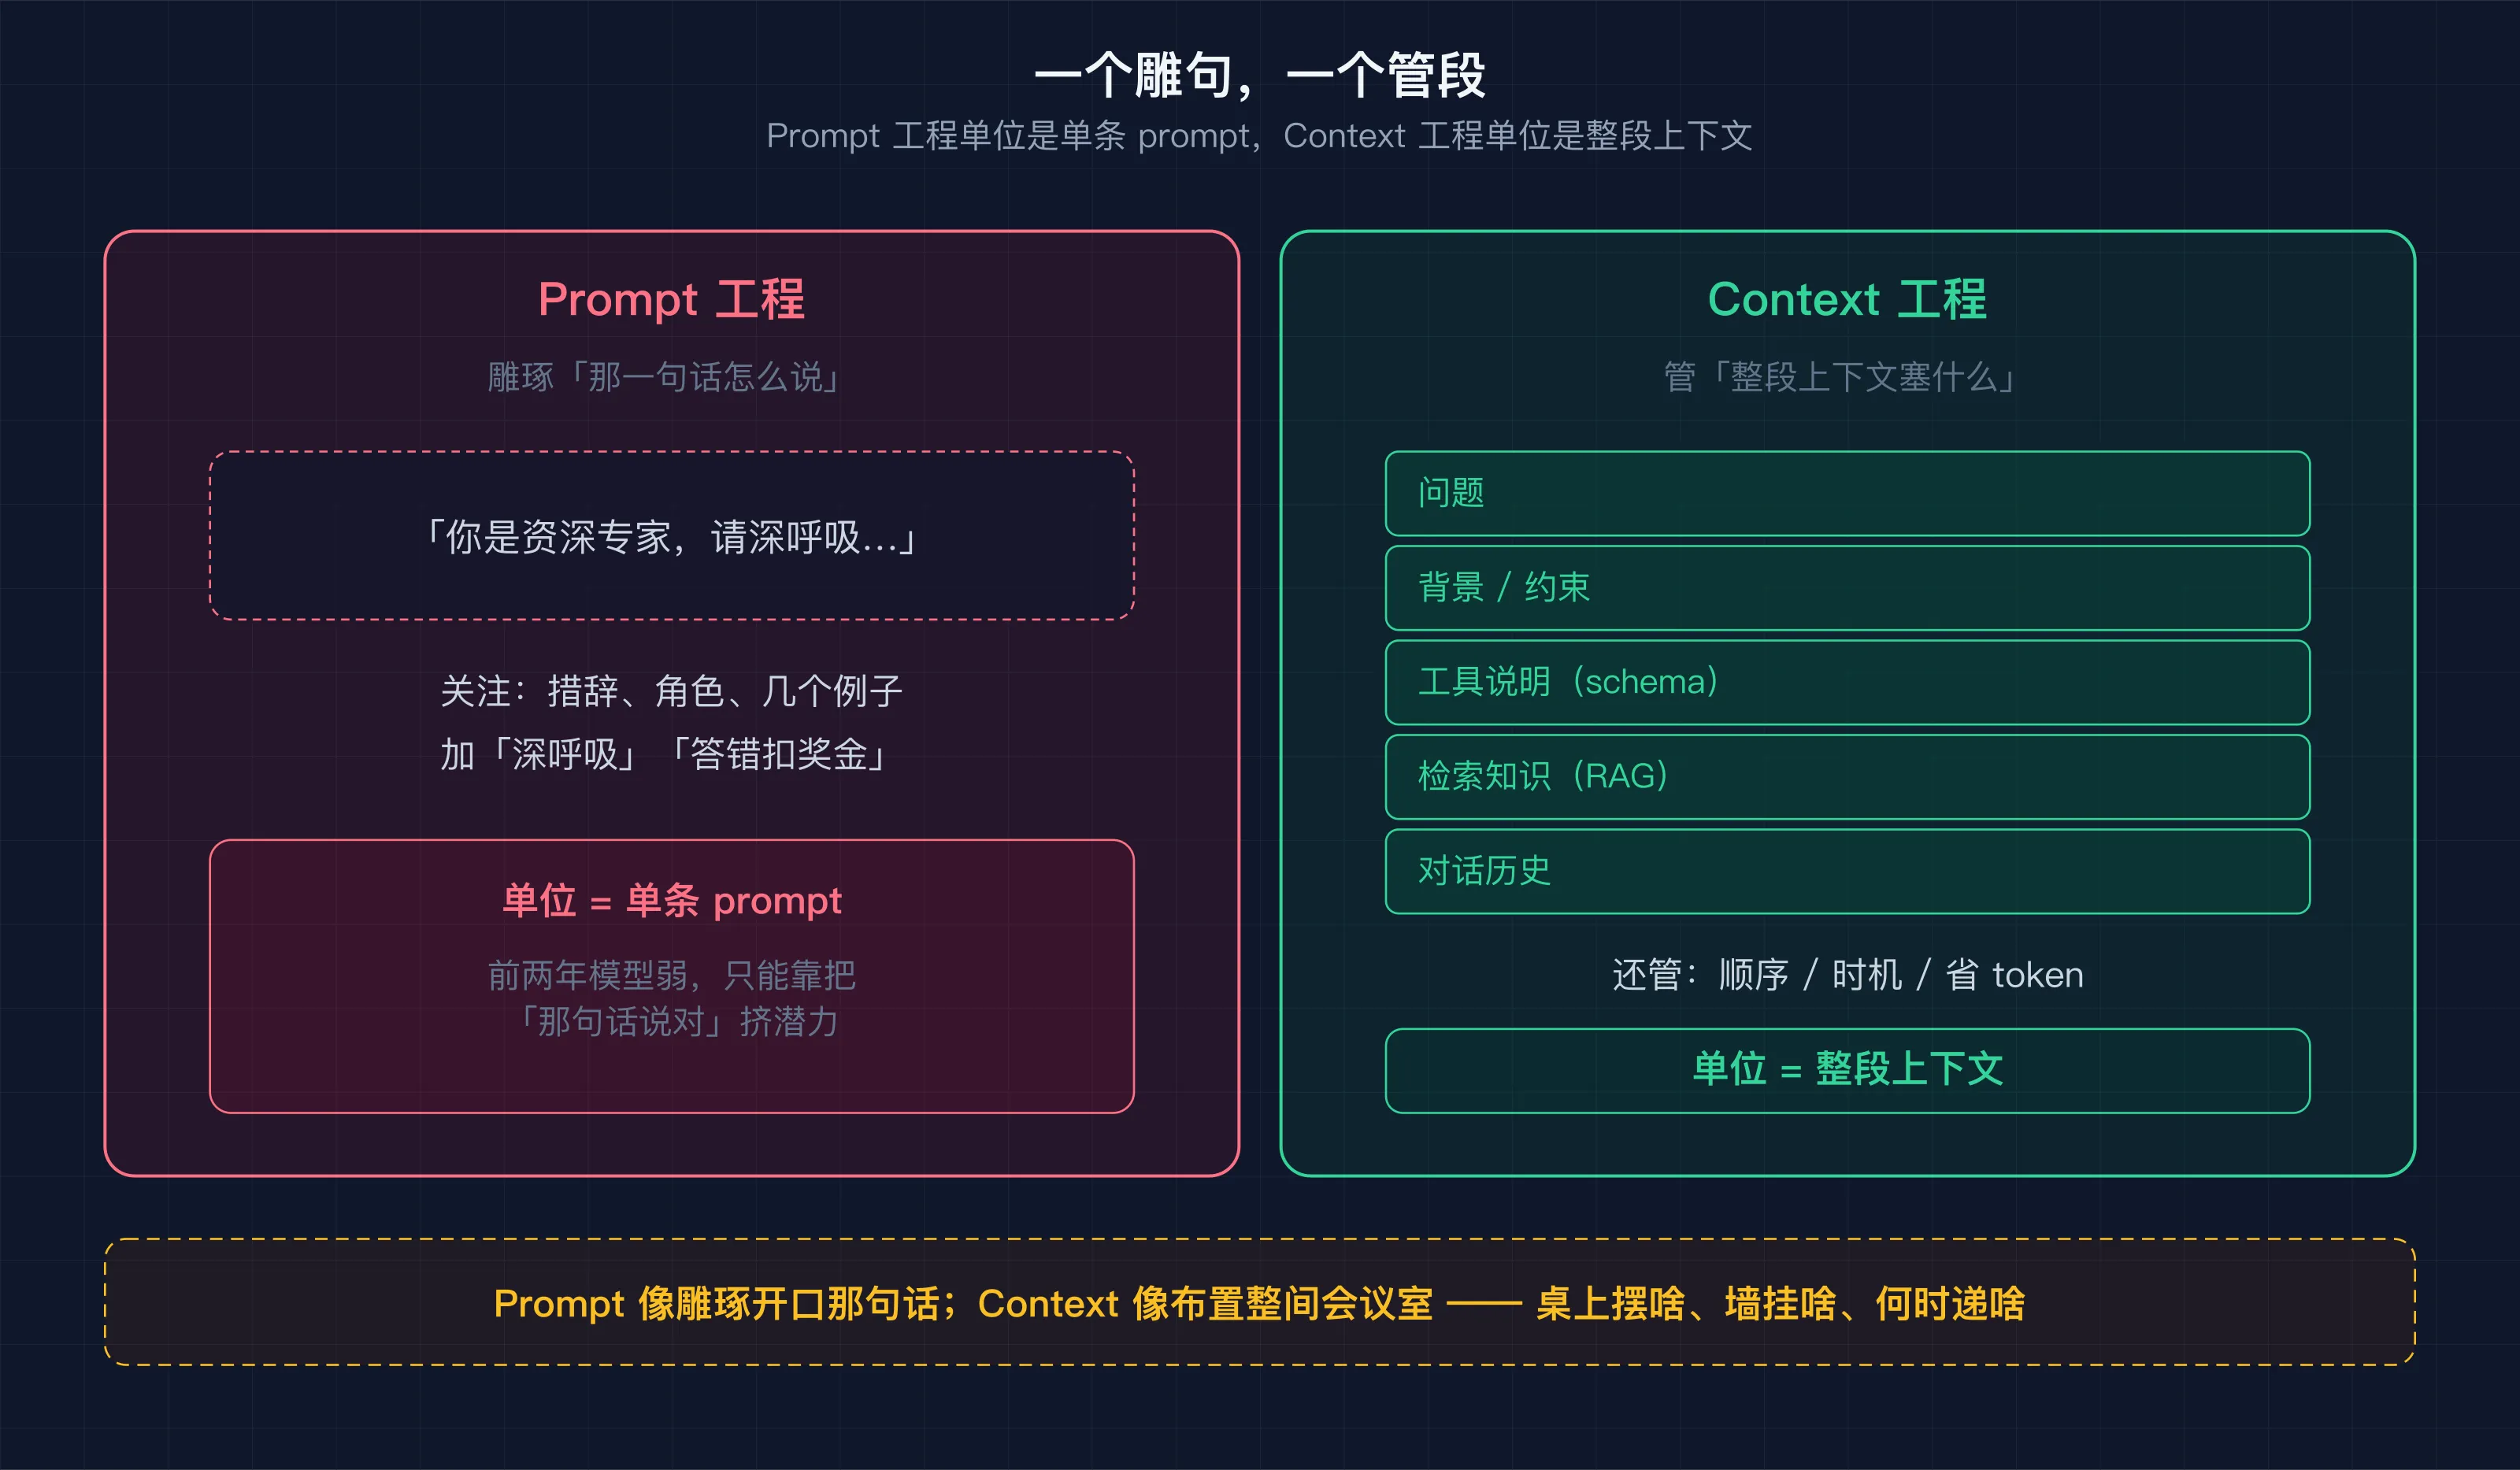
早两年,它叫 Prompt 工程:雕琢「那一句话怎么说」。让 AI 扮演专家、给它几个例子、加一句「深呼吸」、威胁它「答错扣奖金」……那阵子模型还弱、也调不了工具,你只能靠把那句话说对,去挤它的潜力。
2025 年,Shopify 的联合创始人兼 CEO Tobi Lütke 发了条动态,说「Prompt 工程」这名字起错了,该叫 Context 工程——核心是把任务变得能解,所需要的上下文都得备齐。没过多久,Andrej Karpathy(AI 圈的大佬)也发推附议。一大批圈里人跟着改了口。
区别在哪?Prompt 工程的单位,是单条 prompt;Context 工程的单位,是整段上下文——窗口里放什么、不放什么、什么放前面、什么用到了才去查,都在管。打个比方:一个在雕你开口说的那句话,一个在布置一整间会议室——桌上摆什么资料、什么时候递什么文件,都归它管。
到 2026 年,又冒出了新热词:圈里开始喊「记忆工程」(Memory Engineering)——专门研究跨对话记什么、怎么存、怎么检索、什么时候捞回来塞进窗口。有人说得妙:
agent 的记忆,就是「拉长时间轴的 Context 工程」。
你看:三个名字、换了两茬,底下一件事从来没变——模型只能看到一扇有限的窗口,你的全部功夫,就是往里塞对的东西。
Context 工程管什么:往窗口里塞什么
演变史讲完,拿现在最通用的名字——Context 工程——拆开看:它管的就是那扇固定窗口里,该装哪些东西。
一次提问,窗口里通常要塞这些:
- 你的问题:这次到底问什么。
- 背景和约束:你是谁、要干嘛、有什么限制。
- 工具的说明书:模型能调哪些工具、各自要什么参数(探针 4 的 schema)。
- 检索来的知识:从外部库里查到的相关资料(探针 7 的 RAG)。
- 之前的对话:聊过的内容还在窗口里、没被挤掉的那些(探针 5)。
光「塞什么」还不够,还得管:
- 什么顺序:重要的放前面还是后面,模型看得更牢?
- 什么时机:哪些每次都在(预置),哪些用到才去查(动态拉)?
- 怎么省 token:窗口按 token 计、还占地方(这两条底子,下面单独细说)。哪些该精简、哪些该压缩?
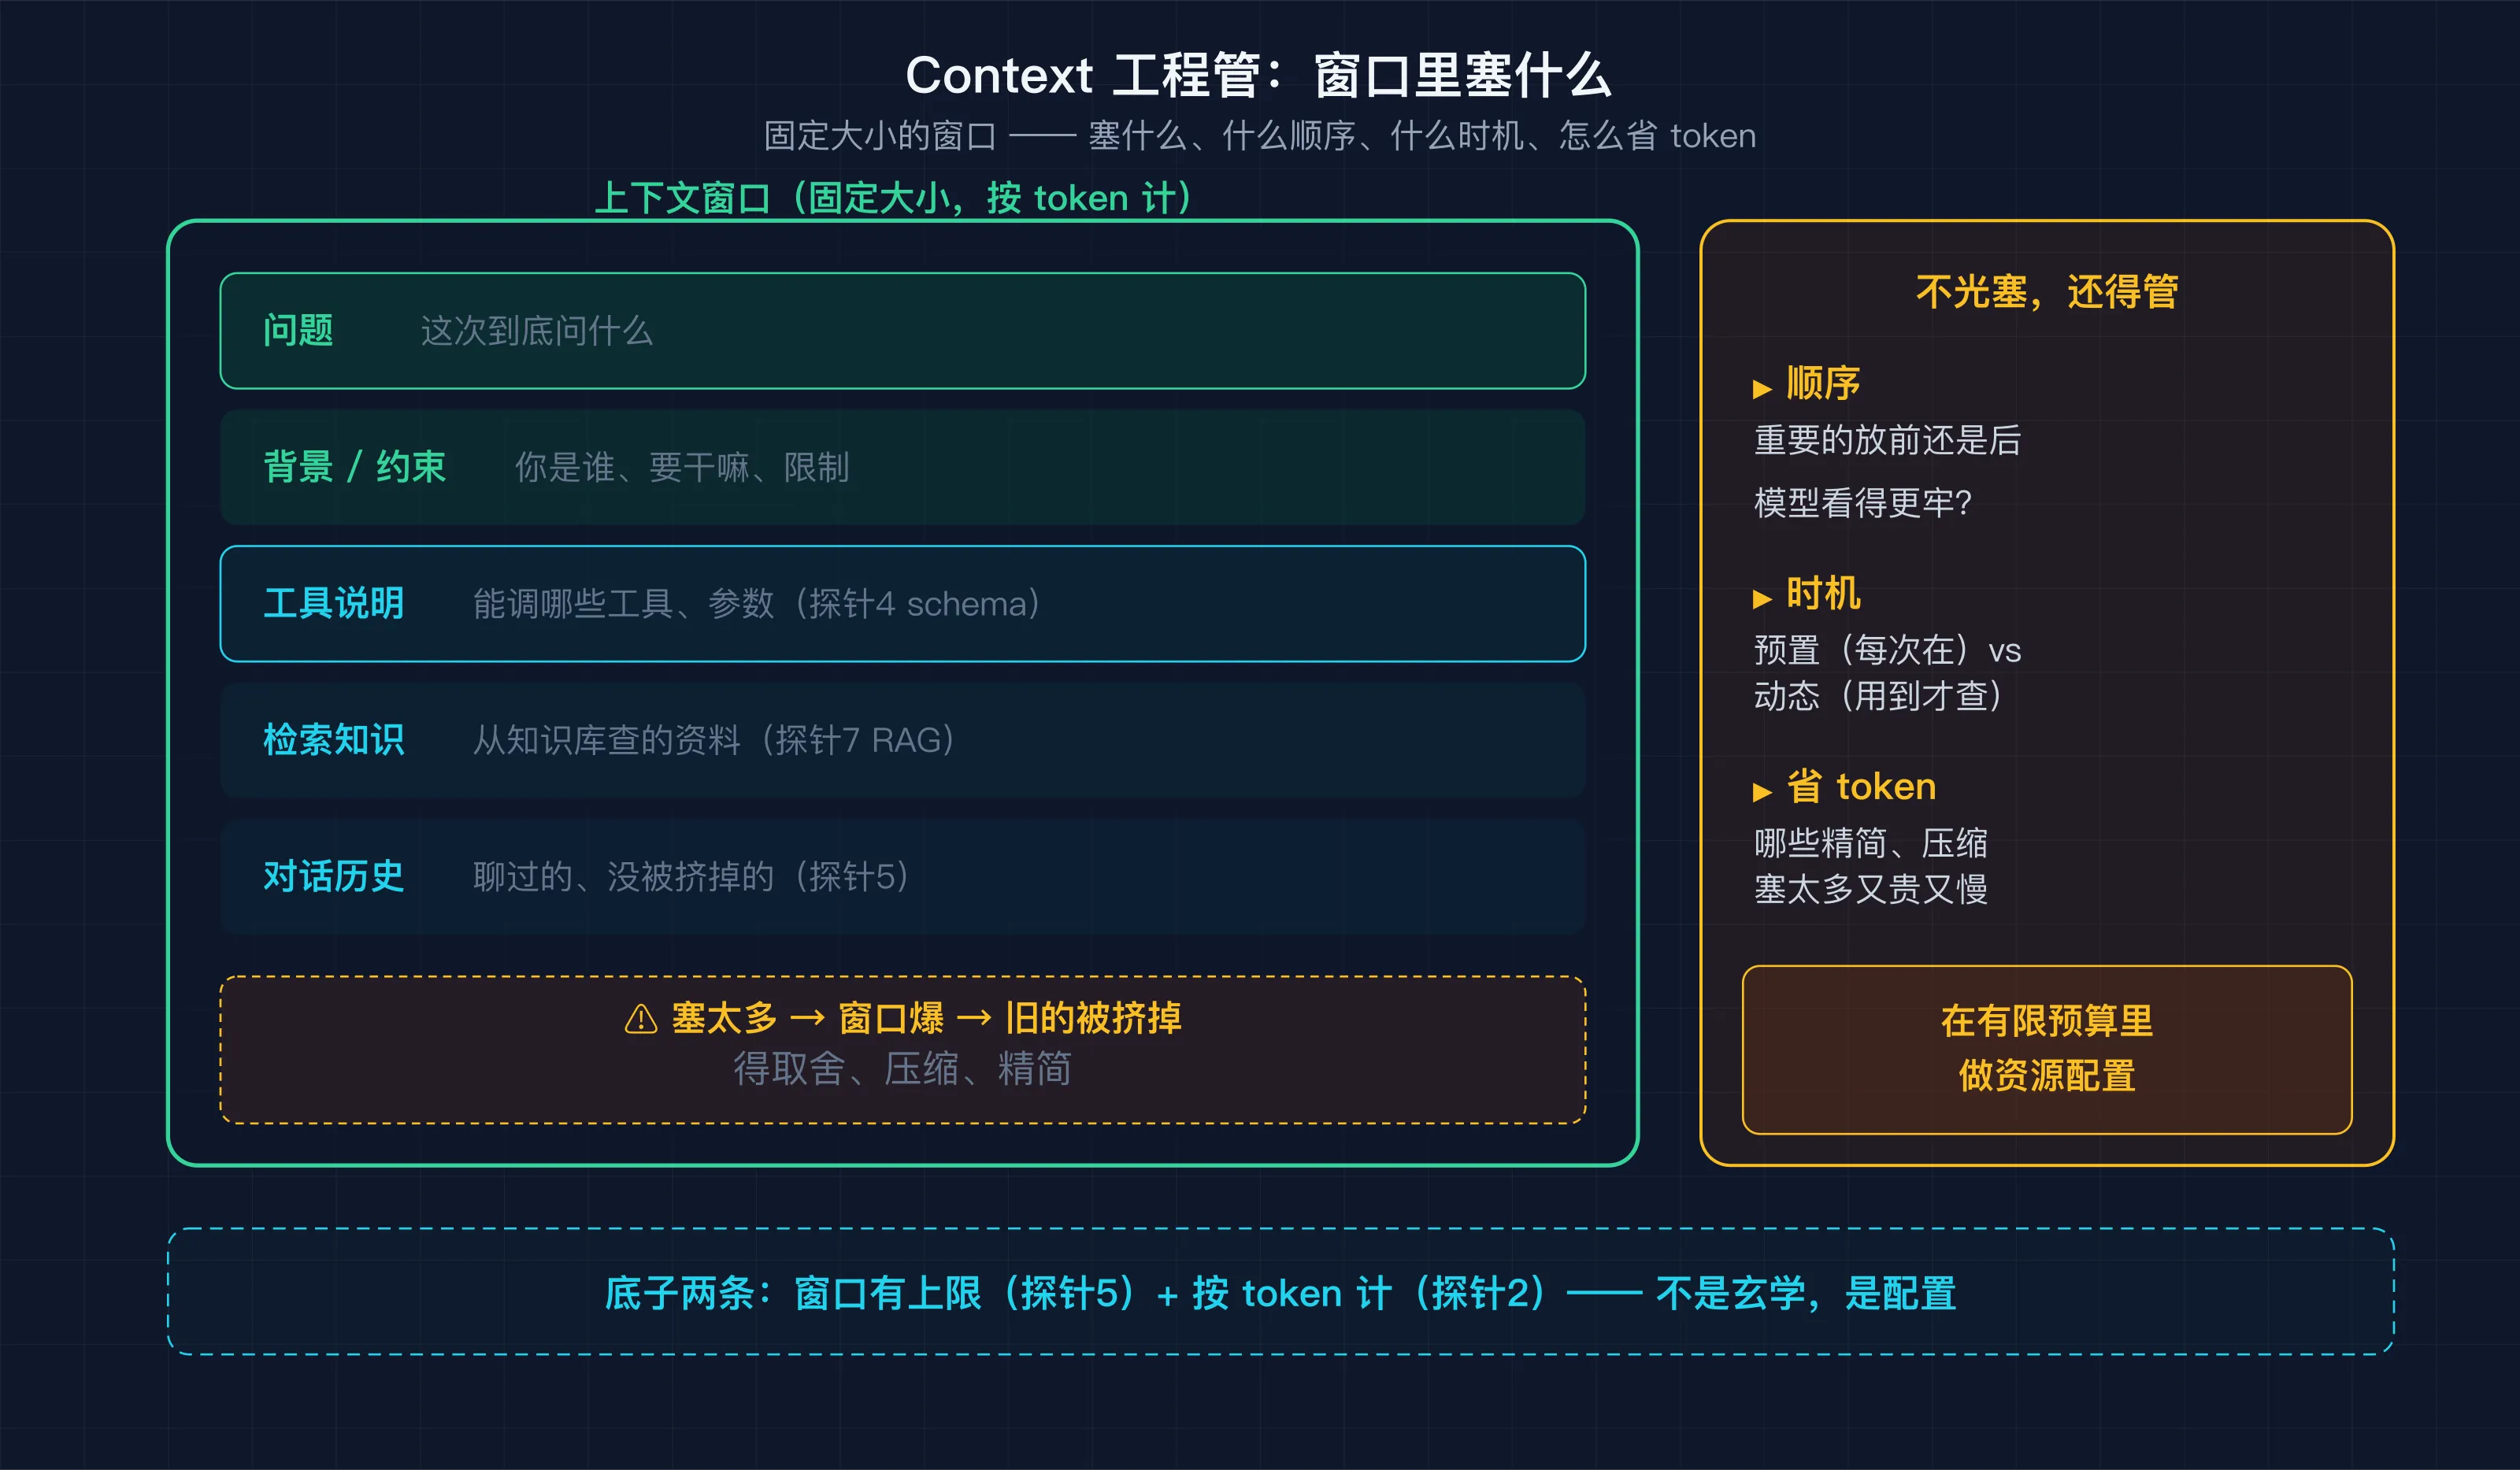
你看,这哪是「写 prompt」,分明是在一个有限预算里做资源配置。
每填一样,都是前面讲过的零件
讲到这你大概发现了:上面那份清单,除了你现场敲进去的问题,剩下每一样都得靠专门的零件往窗口里填——这些零件,前面几乎都拆过。
- 塞预置指令(「背景和约束」那格)——每个 AI 工具背后,都有人提前写好的指令,每次先塞进窗口。
- 塞检索知识(「检索来的知识」那格)——探针 7 的 RAG,临时从知识库捞相关片段塞进去。
- 塞工具说明和工具结果(「工具的说明书」那格)——探针 4 的 Function Calling 把工具的 schema 塞进窗口,模型调完工具,结果经探针 8 的 MCP 链路回喂进窗口。
- 塞持久记忆(「之前的对话」里跨对话的部分)——「持久」说的不是模型记性好,是有人替它在模型外面存了一份档案,每次开新对话,挑相关的塞回窗口。这条,就是上一节那个「记忆工程」干的事。
所以不管是叫 Context 工程还是记忆工程,都不是什么新零件,它是把这些零件组织起来的总纲。前面几讲拆的工具,本质上都是「往窗口里填东西」的不同方式。
底子就两条:窗口有上限,token 要精算
再往下挖一层,这门活的所有纠结,底子就两条,前面都讲过。
一是窗口有上限(探针 5)。固定大小,超了就挤掉旧的。所以你不能什么都往里塞,得取舍。
二是按 token 计(探针 2)。每段文字都占 token、花算力。塞得越多,越慢、越贵,还可能把关键信息挤出去。
这两条一卡,「怎么让 AI 记住」就成了一个实打实的工程问题:在有限的窗口和 token 预算里,把对的信息、在对的时机、用对的方式塞进去。不是玄学,是配置。
我天天在用:Claude Code 的四层填窗口
说说我自己的真实用法。我用 Claude Code 干活,它的上下文是这么四层填进去的:
- CLAUDE.md(预置):项目根目录放个文件,写死规矩——技术栈、命名习惯、哪些事别干。每次对话开头,它会自动先塞进窗口,不用我重复说。
- memory(持久):AI 把值得记的东西写进 memory 文件,下次新对话开头挑相关的带进来。比如我的 memory 里就存着「用户是 6 年 Java 背景、正在转 AI 方向」「这个博客发布工作流踩过哪些坑」,我不用每次交代。这就是开头那个问题的答案:跨对话的「记住」,靠的就是这层。
- skill(按需):一堆技能插件,用到某个才把它的说明塞进窗口,不用就藏着,省 token。
- MCP(动态):外部工具(探针 8)。模型要查数据、读文件,才去调,结果回喂进窗口。
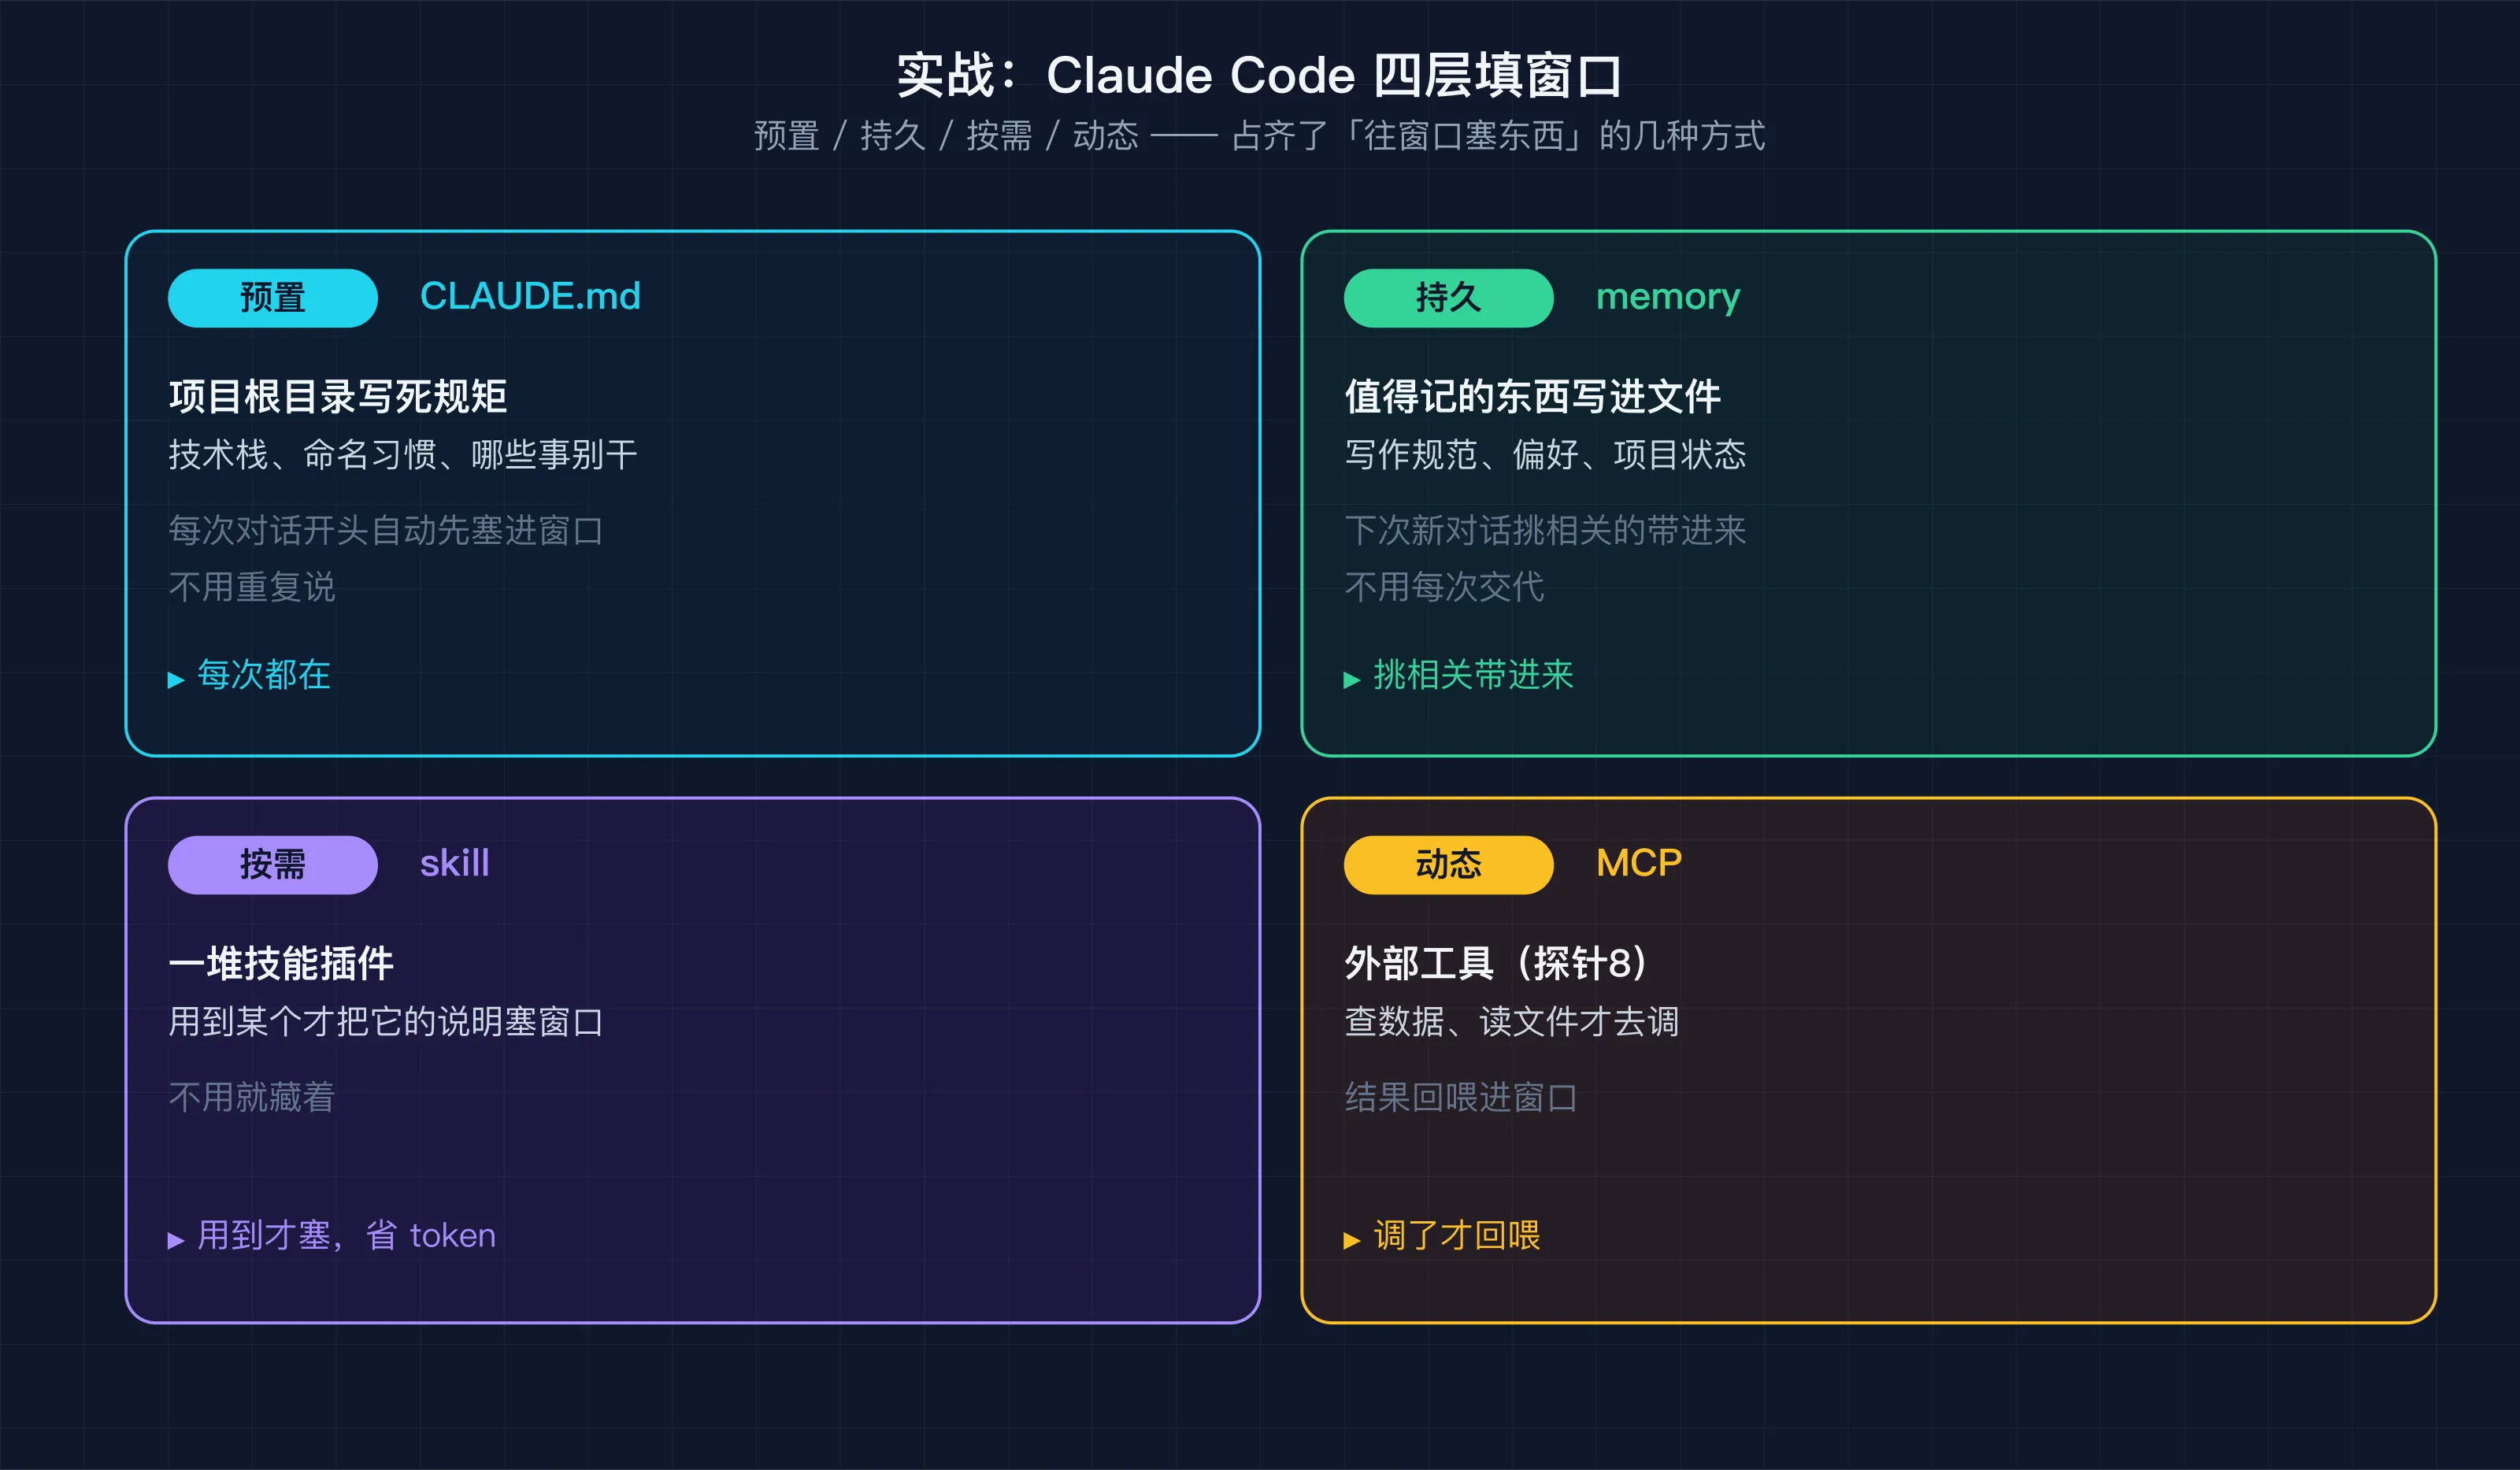
这四层——预置、持久、按需、动态——正好把「往窗口里塞什么」的几种方式占齐了。它「记得」我这个项目、记得我的偏好,秘密全在这:不是它有记忆,是每次开新对话,这四层把我该被记住的部分,重新塞回了窗口。
这根探针挖到了什么
一个「AI 怎么记住对话」的疑问,底下连着三层:
- 机制:模型没有记忆器官,只有一扇固定大小的窗口;所谓「记得」,是旧对话还在窗口里、或有人把它重新塞了回去——它每次都只是重读一遍。
- 演变:管这扇窗口的活儿,名字从 Prompt 工程换到 Context 工程、再到记忆工程,换了两茬;但干的始终是往窗口里塞预置指令、检索知识、工具结果、记忆。
- 底子:窗口有上限,token 要精算。
这一趟,三个热词你都摸过了。以后再刷到「XX 工程已死」「现在流行 YY 工程」,你大概就知道怎么应对:词随便换,你只要盯住两条底子——窗口有限、按 token 计——什么新词都唬不住你。
下一篇,换个方向扎:大模型的「参数量」,可能在骗你——号称几百亿、上千亿的大模型,真正干活的可能没那么多。下回聊。