AI 同步开发多需求不打架:git worktree
你让 AI 改一个功能,改到一半——它已经动了十几个文件,测试跑了一半——产品经理突然甩来一个急活:线上出问题了,现在就看。
你面前三条路,条条疼:
- stash 一下切分支?AI 的会话还开着,它记得的是刚才那份代码。你 stash 完,工作区瞬间换了个世界,会话上下文全作废。
- 再 clone 一份仓库?依赖重装、配置重配,两个 .git 各长各的,一周后你已经分不清哪份是哪份。
- 让急活排队?它是线上问题。
其实还有第四条路。git 在 2015 年 7 月就给出了答案,只是沉了十一年一直没火:一个仓库,可以同时检出 N 个工作区。命令叫 git worktree。
第一幕·认识:它是什么,为什么现在火
一个工作区,只能站一个分支
先看清你每天在用的 git,被「单工作区」锁得有多死。
一个 git 仓库分三层:最底层是仓库本身(.git 目录),所有提交历史、所有分支都在这,只有一份;中间是暂存区(index);最上面是工作区,就是你正在编辑的那堆文件。
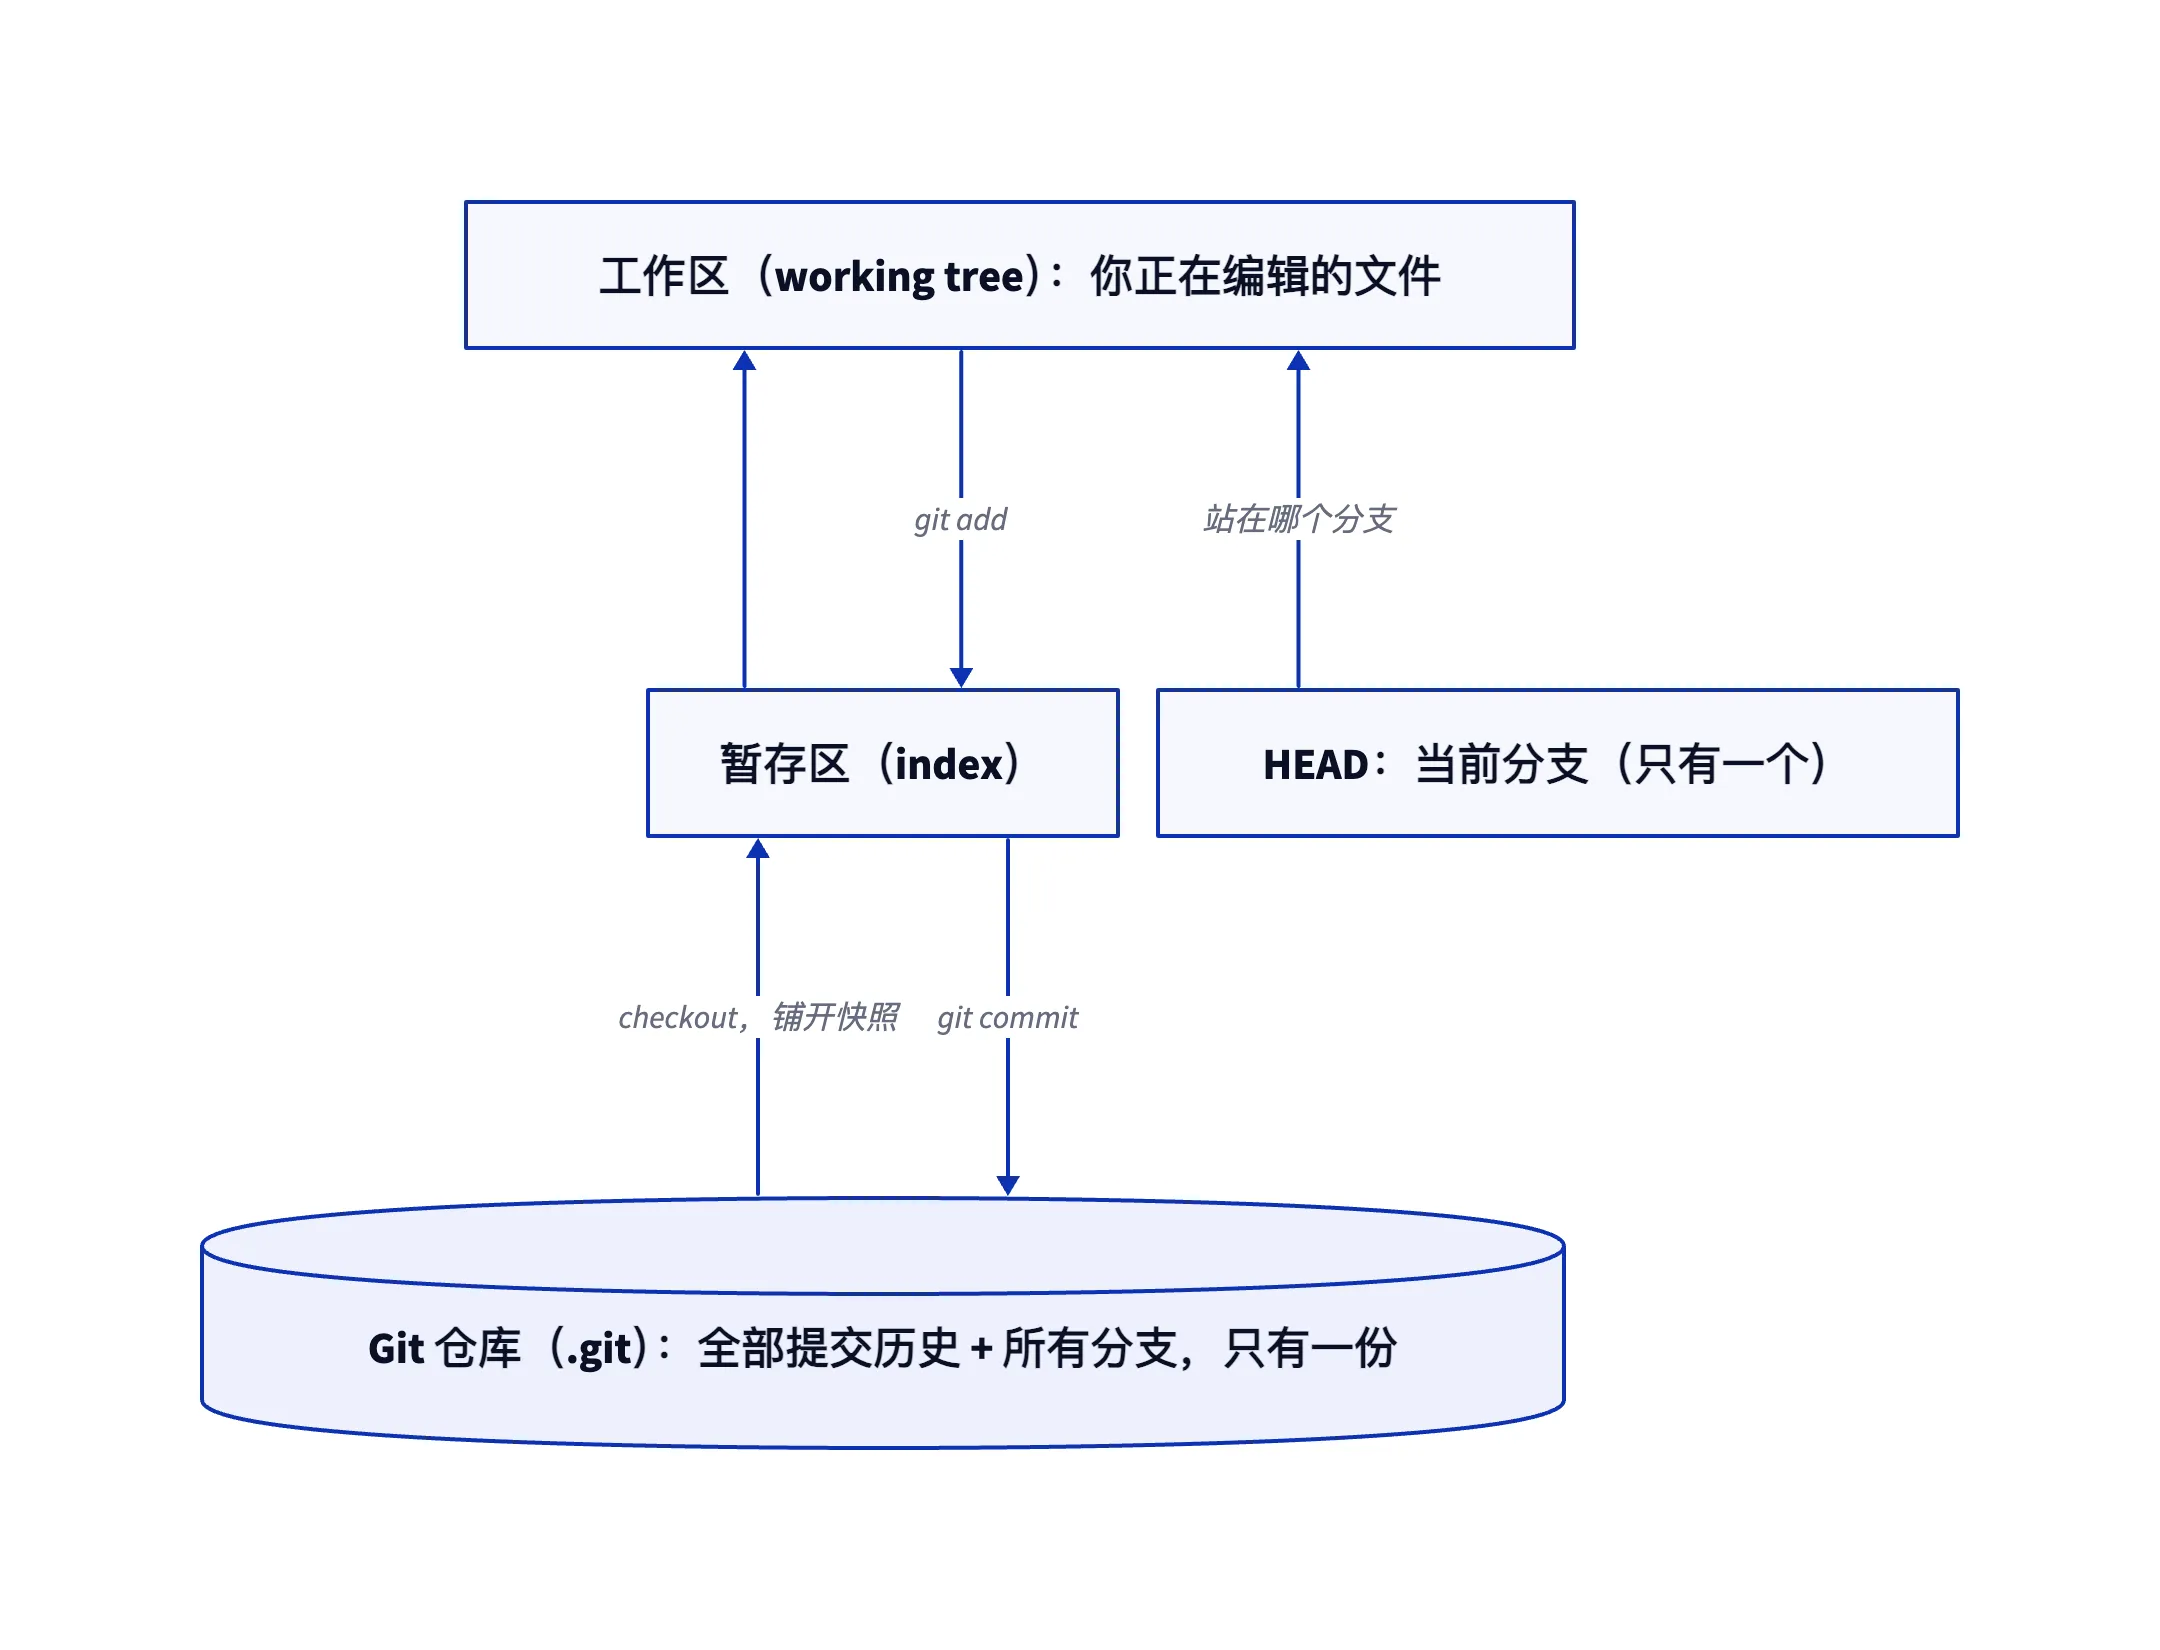
git checkout 的本质,是把某个快照「铺」到工作区里。问题在于:HEAD 只有一个,工作区也只有一个。所以同一时刻,一个仓库只能「站」在一个分支上。想换分支,就得把整个工作区换掉——文件、暂存区、HEAD,全部重置。
这套东西的底层是一套指针系统:提交是链条,分支只是指向某个提交的 41 字节指针文件,HEAD 又指向分支——后面 worktree 的所有行为,都能从这套指针模型推出来。
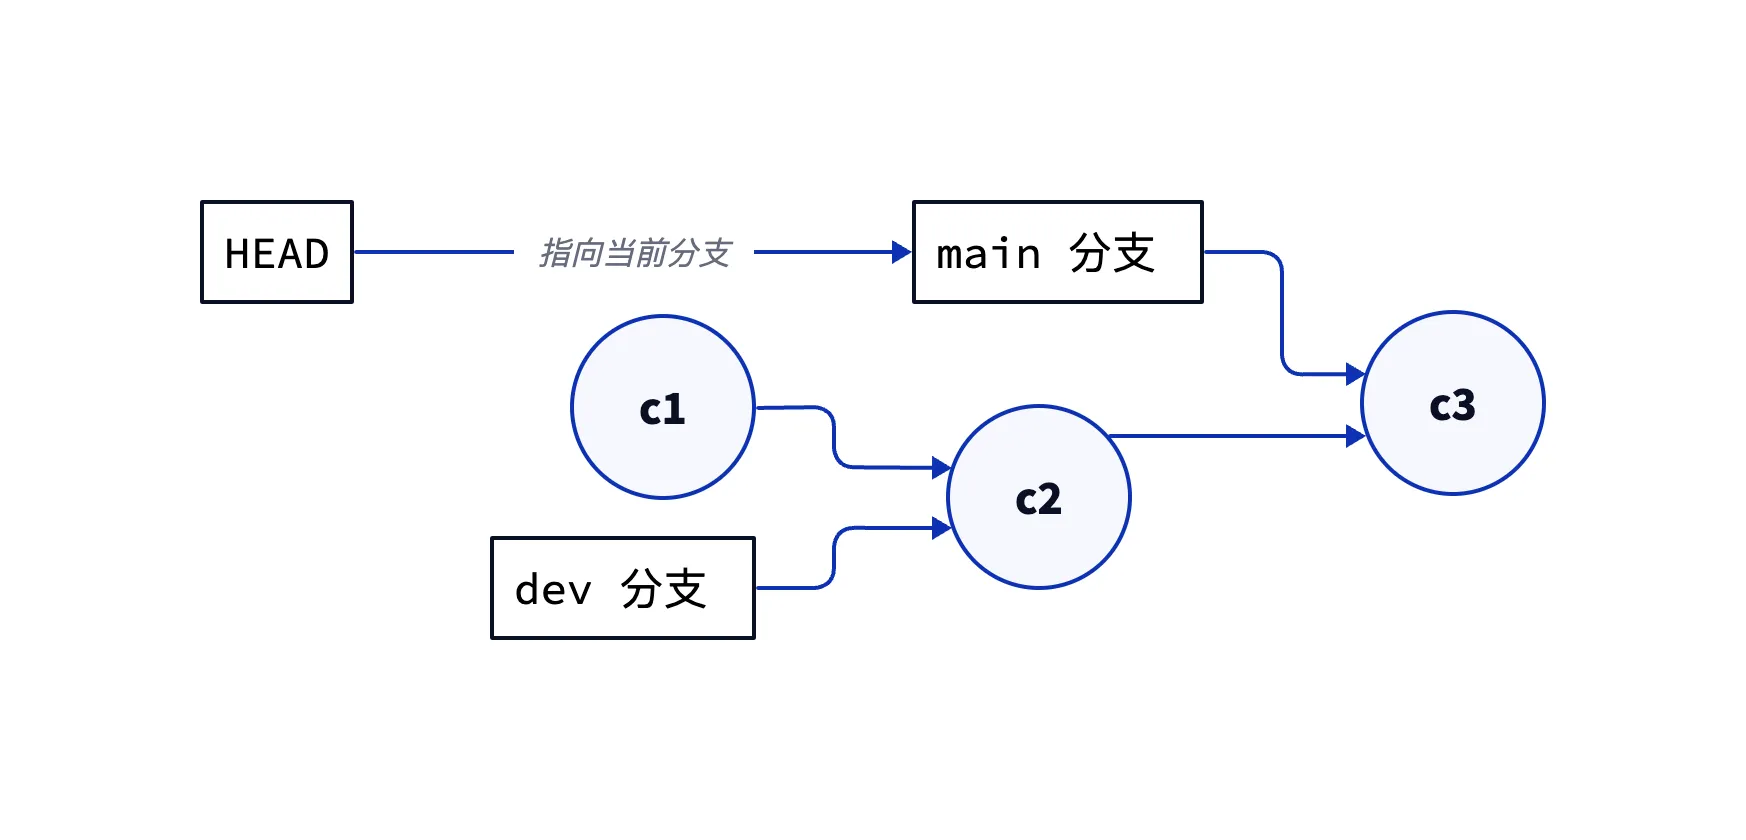
这不是 bug,是 2005 年的默认设计:一个人,一台机器,一次干一件事。十几年没人觉得不对——因为人写代码,本来就快不到哪去。
worktree:不是复制仓库,是多开工作区
一条命令:
git worktree add ../myproject-hotfix -b hotfix-logingit 会在仓库外面新建一个完整的工作目录:有自己的工作区、自己的暂存区、自己的 HEAD,站在你指定的新分支上。
关键在于:仓库还是那一个。.git 没有被复制,提交历史和分支仍然只有一份,存在主仓库里。落到文件系统上看更直观——主工作区的 .git 是个目录(真身),分身目录里的 .git 是个只有一行路径的文件,两边互相登记在册:
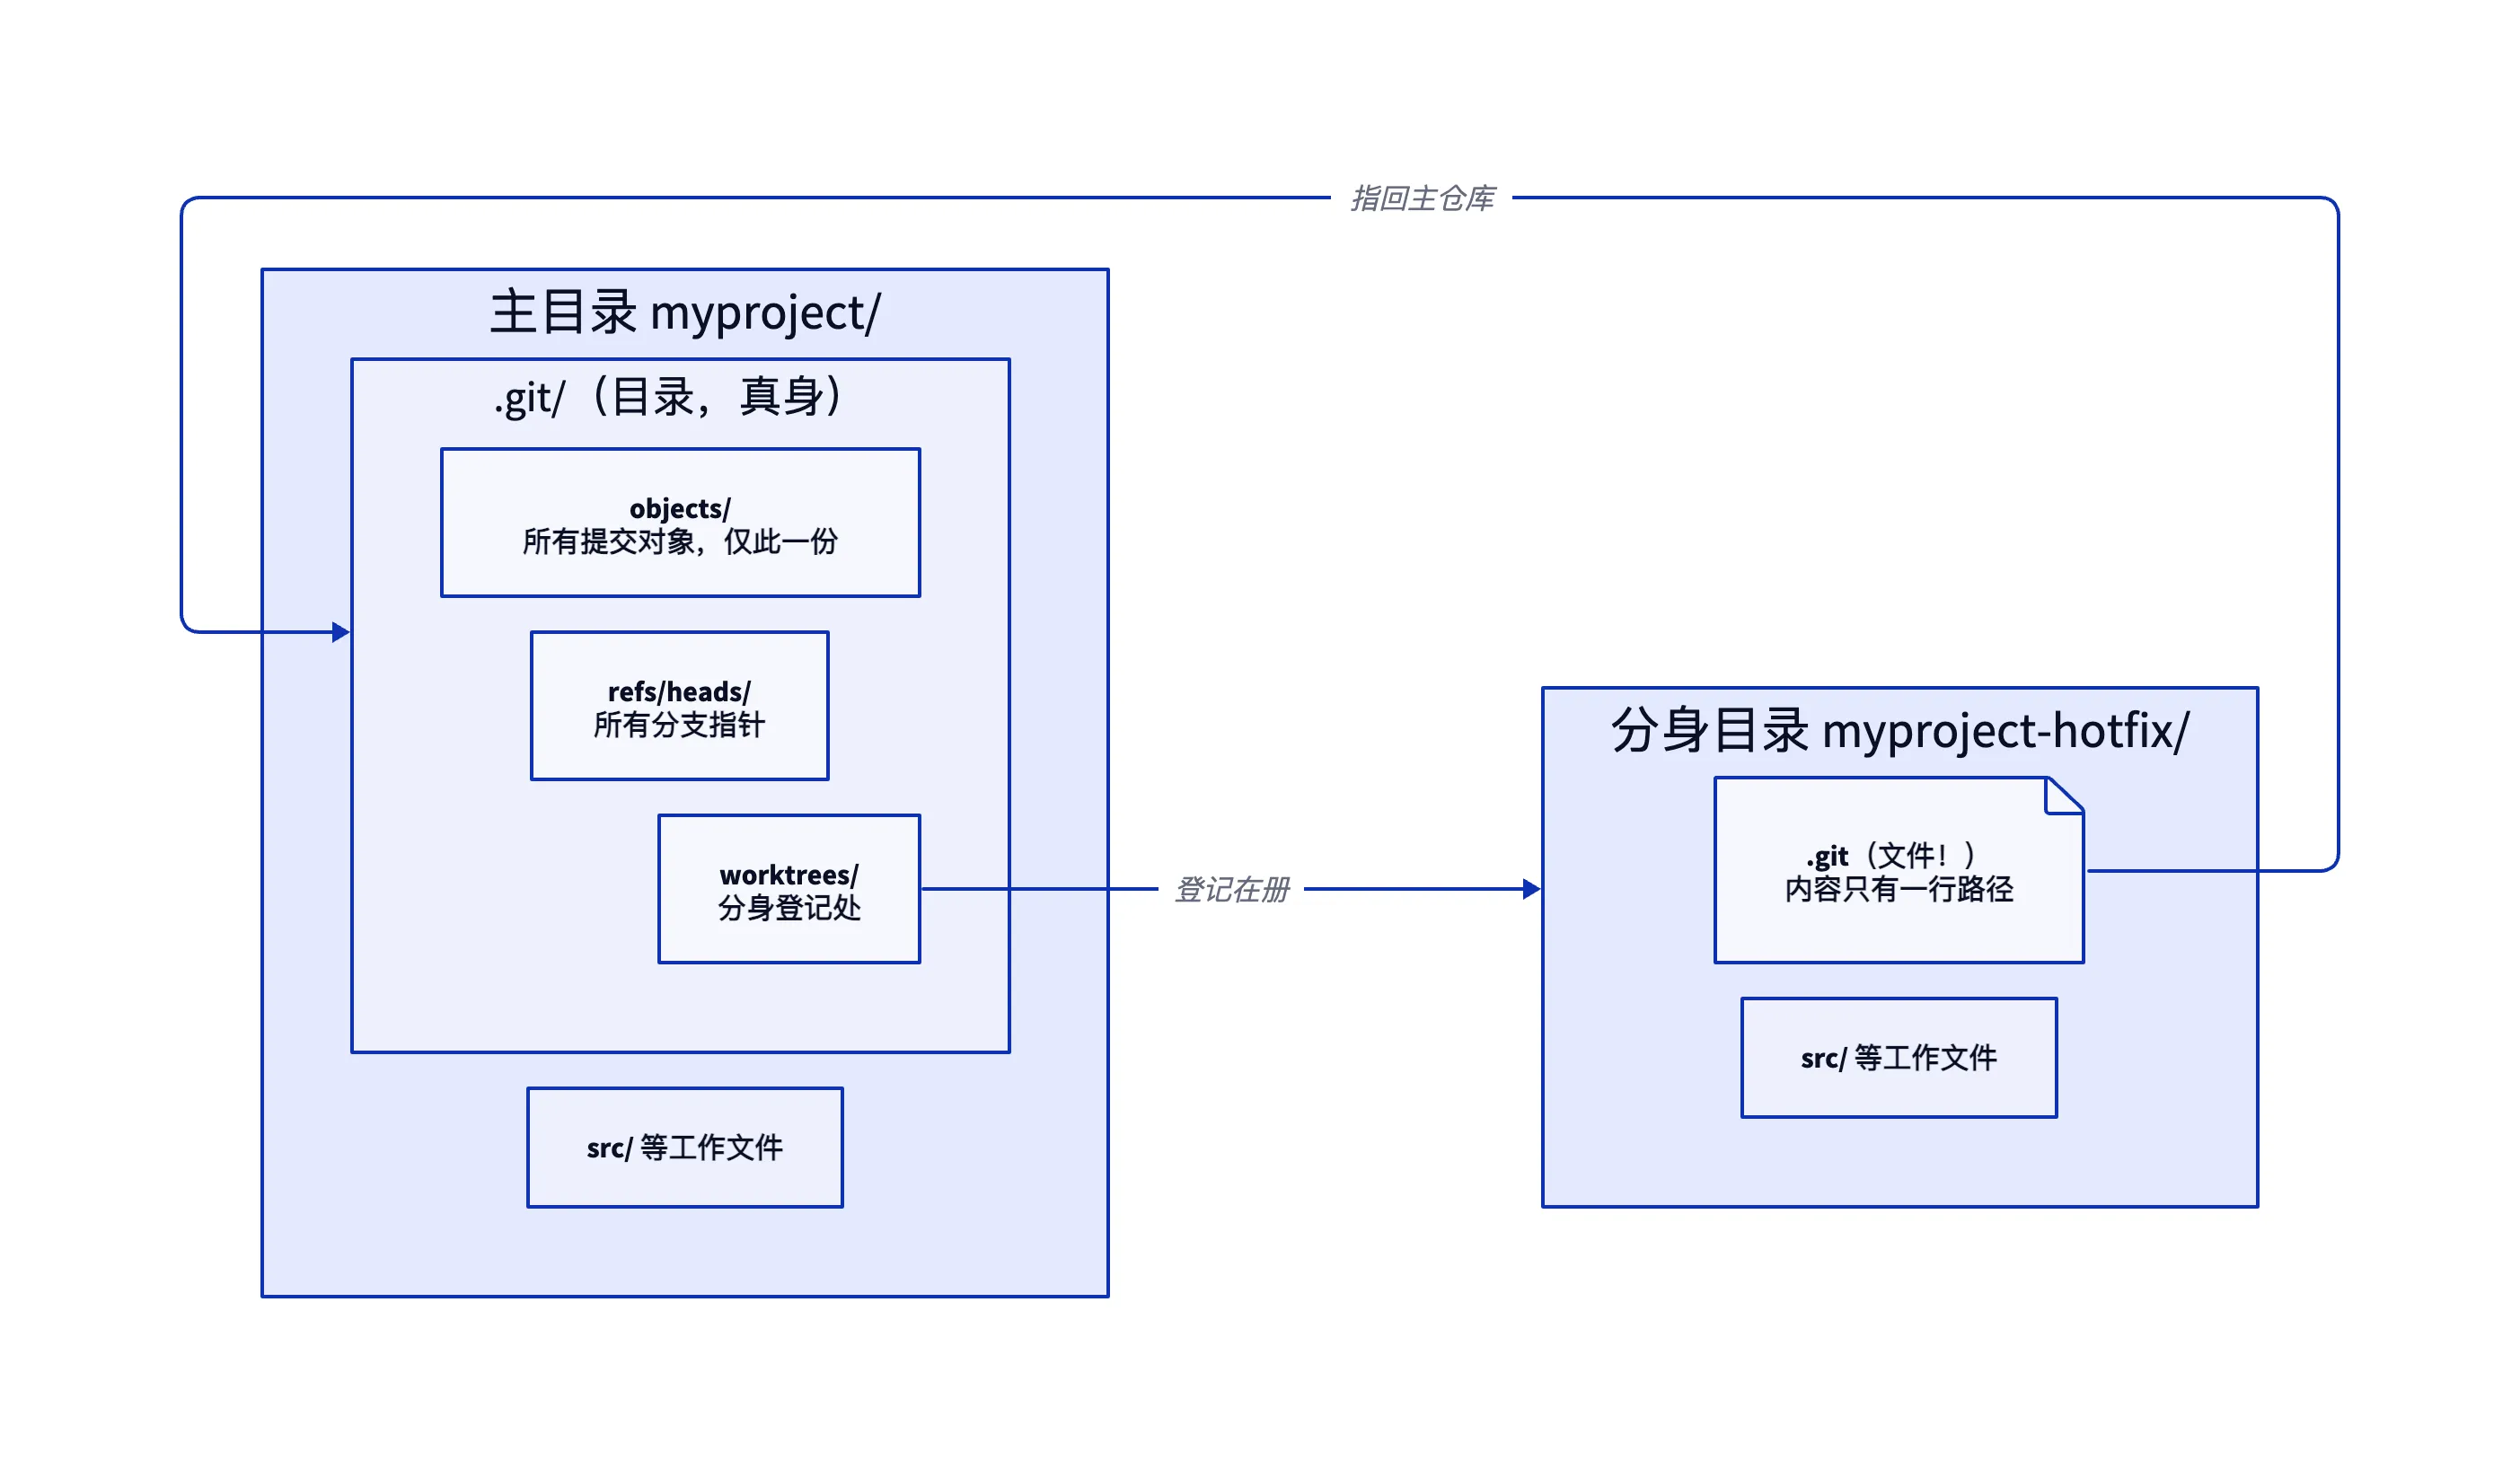
比喻:不是再买一套房,是公司本来有个大档案室(.git),现在给每个项目组各分一间独立办公室(工作区)。档案共享,办公室互不打扰。
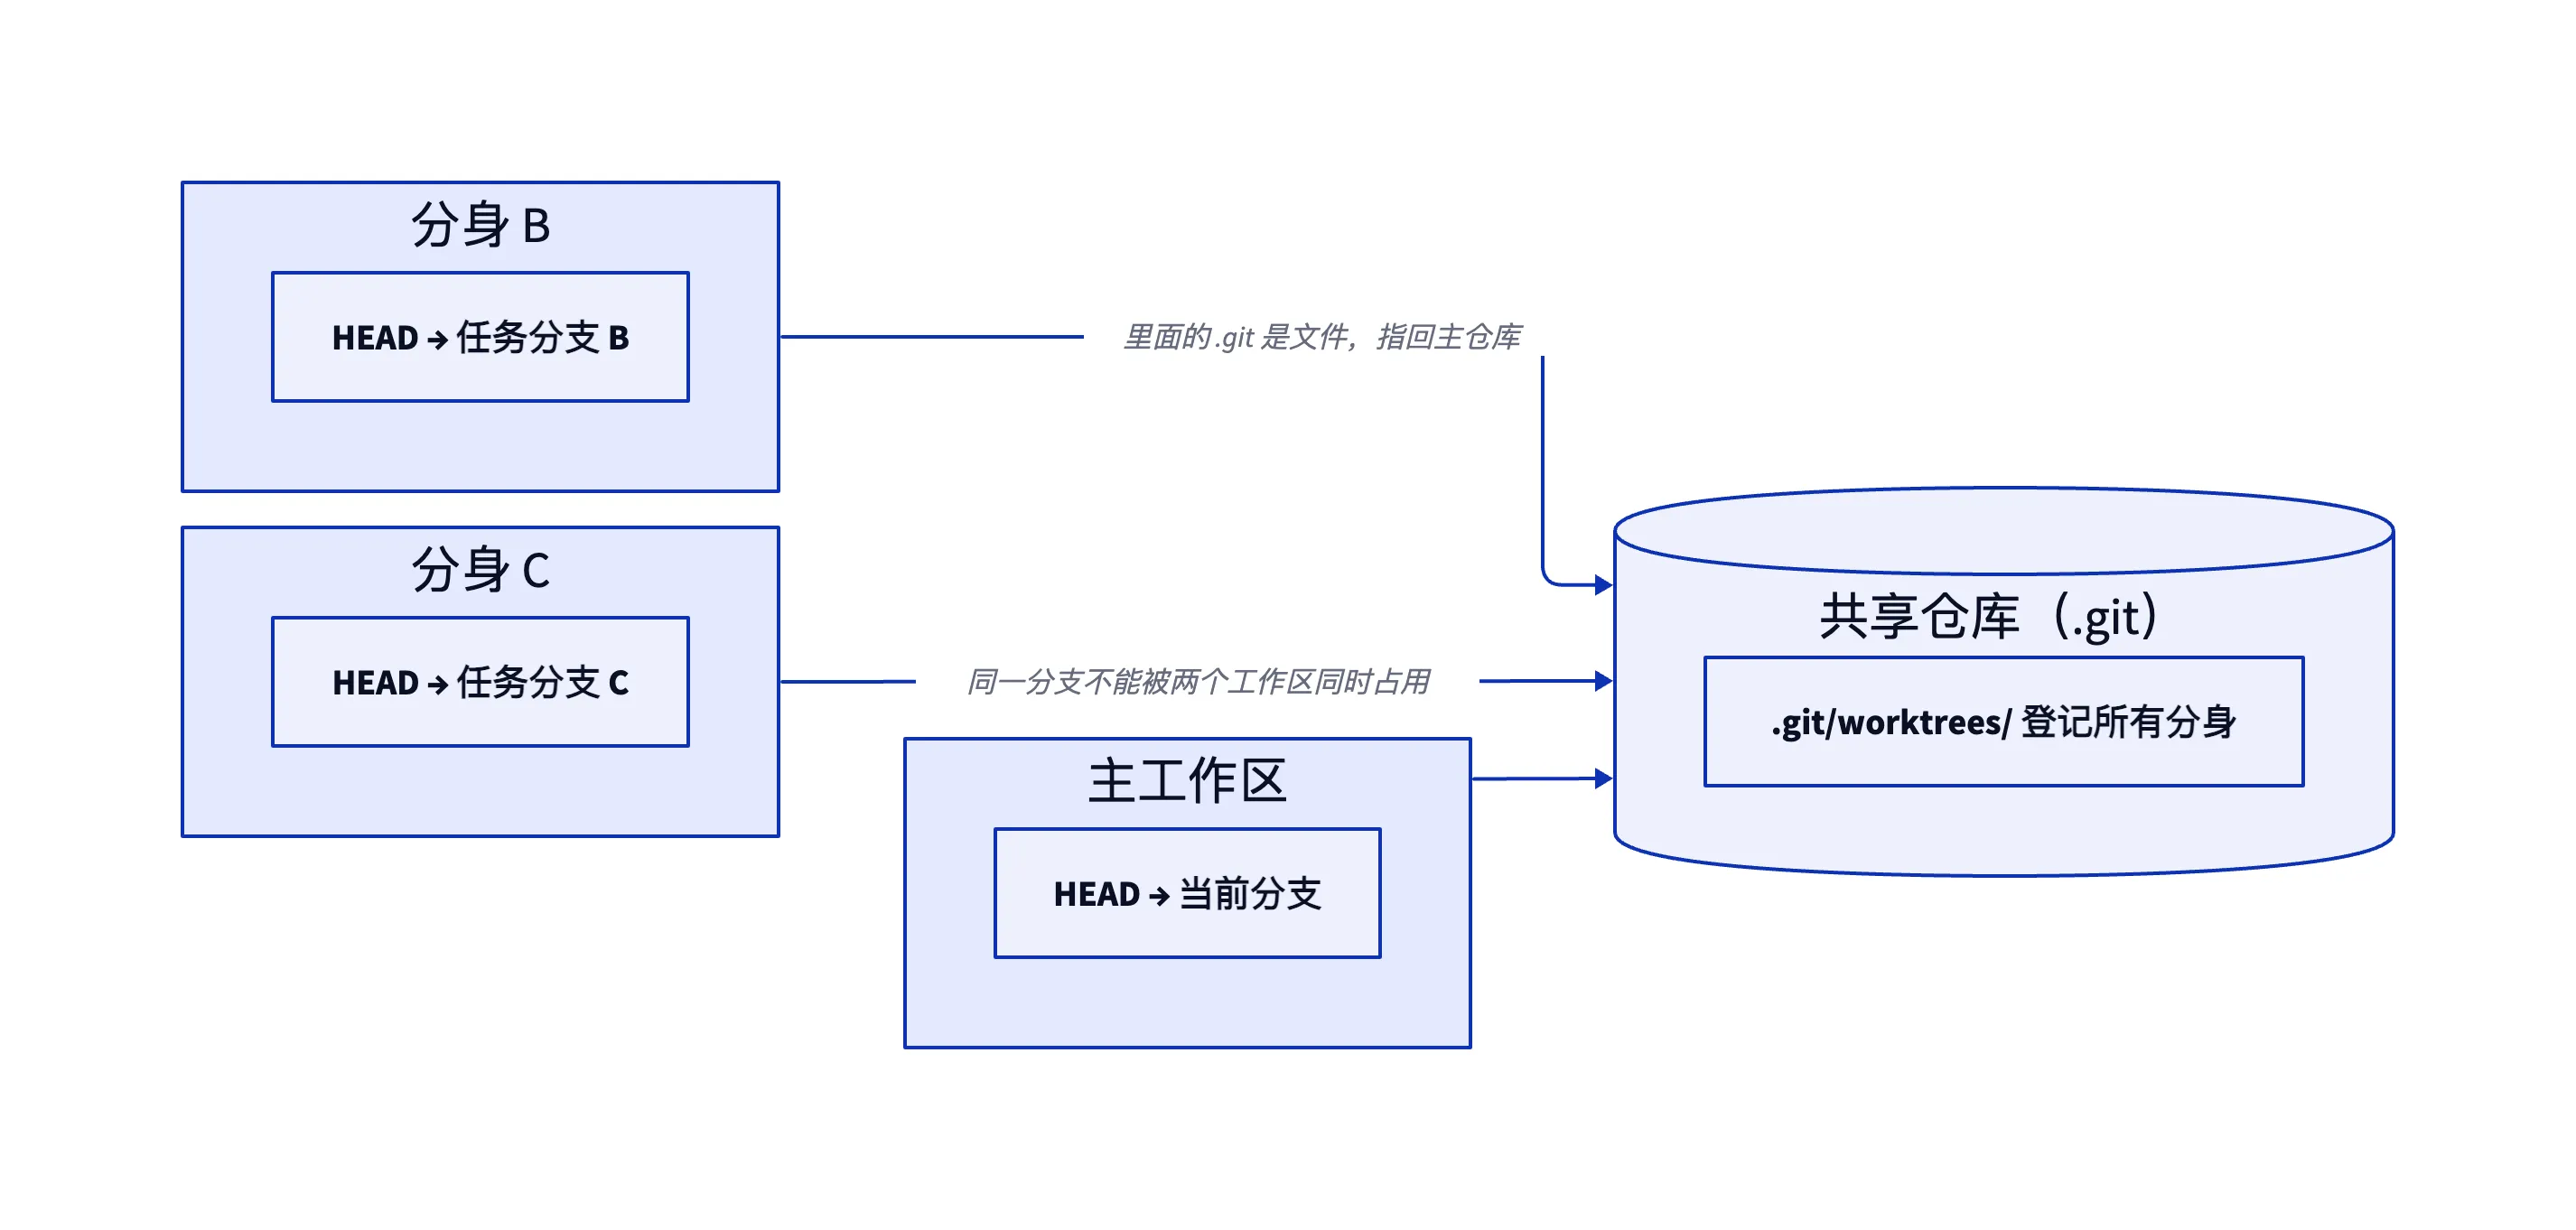
还有一条容易踩的保护机制:同一个分支,不能被两个工作区同时占用。你试着在第二个 worktree 里 checkout 主工作区正站着的分支,git 会直接拒绝(老版本报 already checked out,新版本报 already used by worktree at),它防的就是两边同时改同一份代码。
校准一下:它不是「复制了一份代码」
很多人听完流程——开个目录、进去开发、提交、删掉目录——第一反应都是:「这不就是把代码复制一份去改,改完删掉?」流程感觉是对的,但用「复制」建模,四个预测全错:
- 你会以为新目录要跟原目录「同步」才能看到对方的提交。实际两边共享同一个 .git,任何一边的提交,另一边零延迟可见,不存在「同步」这个动作。
- 你会以为删掉那个目录,成果就跟着没了。实测
rm -rf掉整个 worktree 目录后,分支上的提交原封不动,随时能取回——目录只是消耗品,提交才是资产,先删目录、后合并,完全合法。 - 你会以为两份「复制」可以各自检出同一个分支。实际 git 直接拒绝——就是上面那条保护机制。
- 你会以为磁盘翻倍。实际历史和对象库全仓库仅此一份,真正「复制一份」是 git clone 干的事,代价是两套 .git 各自为政,还得维护同步关系。
还有一个坑同样源于这个误解:复制会连 .gitignore 的文件一起带过去,而 worktree 是全新检出,只带 git 管着的文件——你的 .env、node_modules、CLAUDE.md 统统不会出现(AI 时代这是头号坑,第二幕实战细讲)。
所以更准的心智模型还是那个办公室:复制的只是「桌面」,档案室永远只有一间。
为什么 2026 年突然翻红:AI 太快了
这功能沉了十一年,为什么现在到处都在讨论?
因为 vibe coding 时代,AI 把「写代码」的速度提上来之后,单工作目录从「够用」变成了「瓶颈」。
以前的节奏是一个任务写完、提交、切下一个。现在 AI 会话几乎不要钱,你完全可以让一个 AI 修 bug、一个 AI 写新功能、自己再 review 第三个任务的代码——三件事同时推进。
但只要它们挤在同一个工作目录里,就是灾难:A 会话刚改完的文件,被 B 会话切分支换掉了。stash 救不了——AI 会话的上下文是绑定工作区状态的。它记得自己改了哪些文件、改到哪一步、哪个测试跑过了;你一 stash 一切分支,工作区换了个世界,这些记忆全部作废,切回来还得从头对齐。人被 stash 折腾一下还能忍,AI 会话直接废掉。
物理隔离才是正解:每个任务一个 worktree,各自目录、各自分支、各自提交,互不知道对方存在。所以你会看到 2026 年的景象:
-
Claude Code 把 worktree 做成了一等公民:
claude --worktree 任务名直接在隔离 worktree 里启动会话,子代理可以声明isolation: worktree,还提供了.worktreeinclude文件——用 .gitignore 的语法声明「这些被忽略的配置要自动带进新 worktree」。 -
社区冒出一批专门管理 worktree 的工具:Worktrunk、Conductor、Vibe Kanban、Claude Squad……本质都是给「一仓多线」(本篇就是一仓三线)加个管理层——看板或会话面板。
-
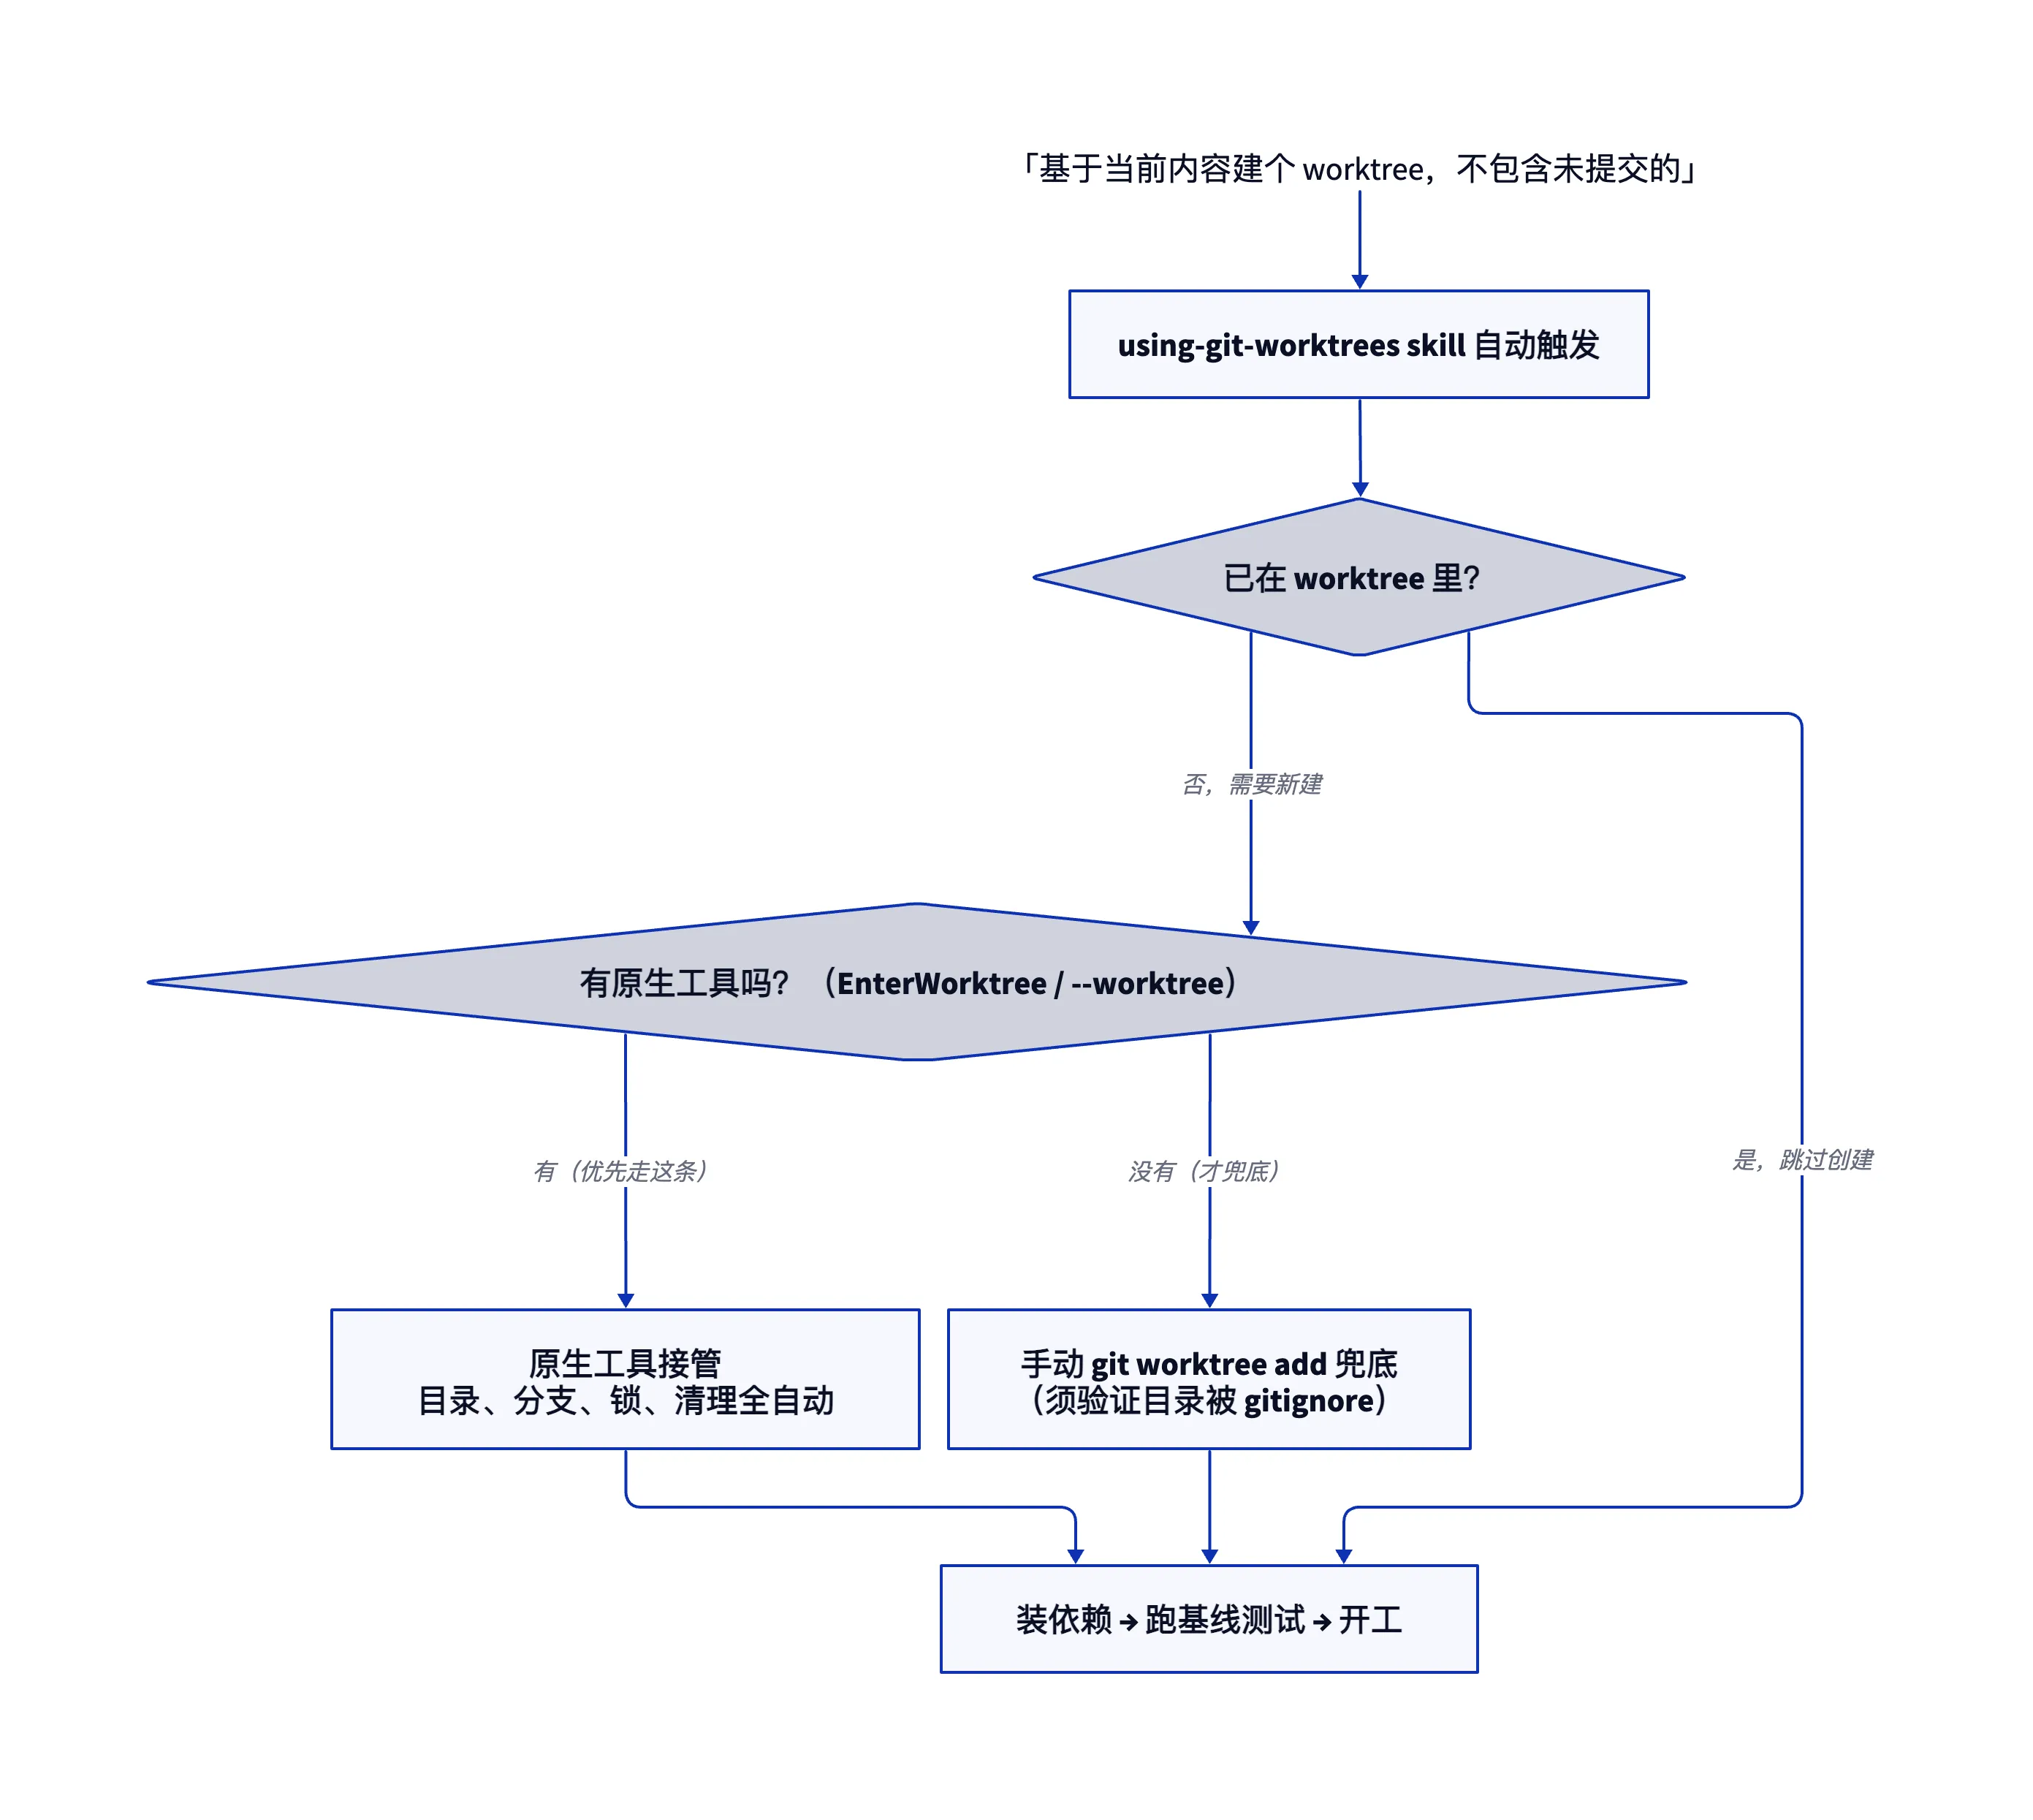
连「怎么建 worktree」都有 skill 代劳:流行的 superpowers 技能库里有专门的 using-git-worktrees,核心原则是「优先平台原生工具,手动 git 建只做兜底」。
它的理由:绕过原生工具,会造出宿主看不见也管不了的「幻影状态」。
你只需要说一句人话:「基于当前内容建个 worktree,不要未提交的改动」,剩下的它自己路由。
工具热不热闹不重要,重要的是这个共识:AI 并行开发的瓶颈,落在了 git 的单工作目录上。
第二幕·实战:一仓三线,从开工到合流
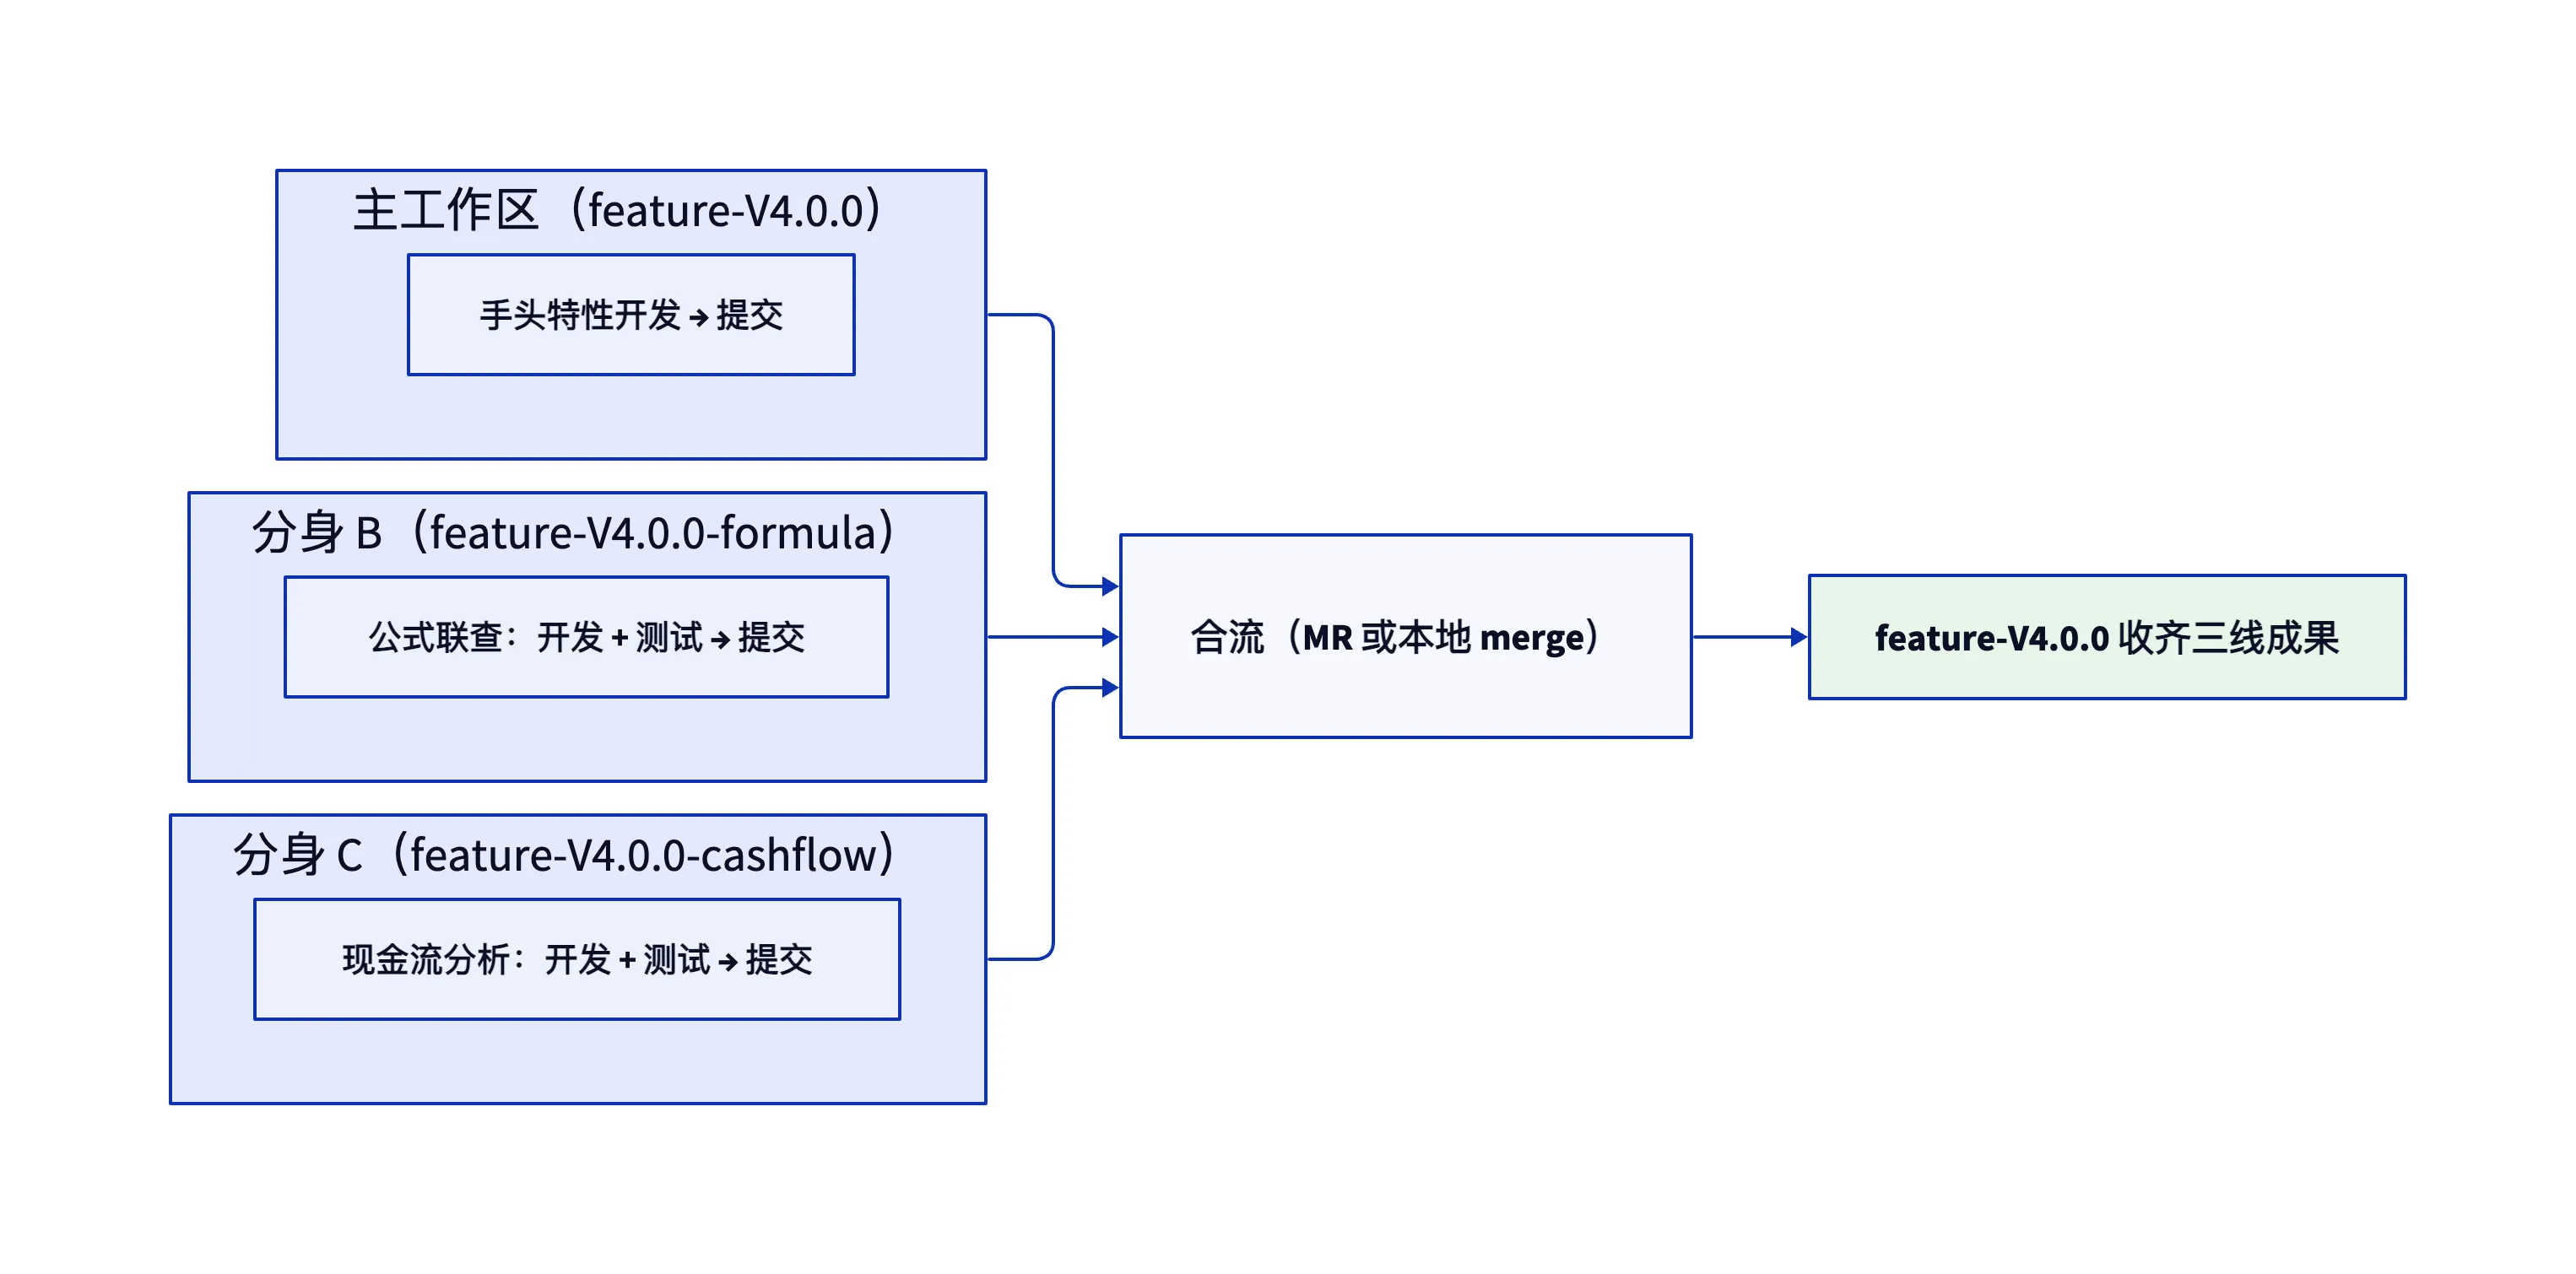
讲个我自己的真实场景。手头一个 Java 多模块项目,某天早上同时存在三份技术方案:
- 主工作区:一个改到一半、还没提交的特性,四十多个文件动过了;
- 任务一:公式联查,技术方案评审完,代码未动;
- 任务二:历史现金流分析,同样方案就绪、代码未动。
要求:三线并行,提交各自独立,互不影响。整条流水线长这样:
开工:一句人话,或者三条命令
AI 时代的开工方式,是对着项目说句人话——「基于当前内容建一个 worktree,不包含未提交的内容」。会话自动触发了技能库里的 using-git-worktrees,按「原生工具优先、手动兜底」的路由走完全程,你说人话,skill 管路由:
不用 AI 的话,等价的是三条命令(效果完全一样):
# 基于当前所在分支(feature-V4.0.0)的顶端,各开一个任务分支 + 独立工作区
git worktree add ../myproject-formula  -b feature-V4.0.0-formula
git worktree add ../myproject-cashflow -b feature-V4.0.0-cashflow

# 验证:应该列出三行——主工作区 + 两个新分身
git worktree list最常被问的问题:主工作区那四十多个未提交的文件会受影响吗?不会。worktree add 只做两件事:往 .git/worktrees/ 里写登记信息,在仓库外面新建目录。主工作区一个字节都不动——主工作区本身就是第三条线,继续手头特性。
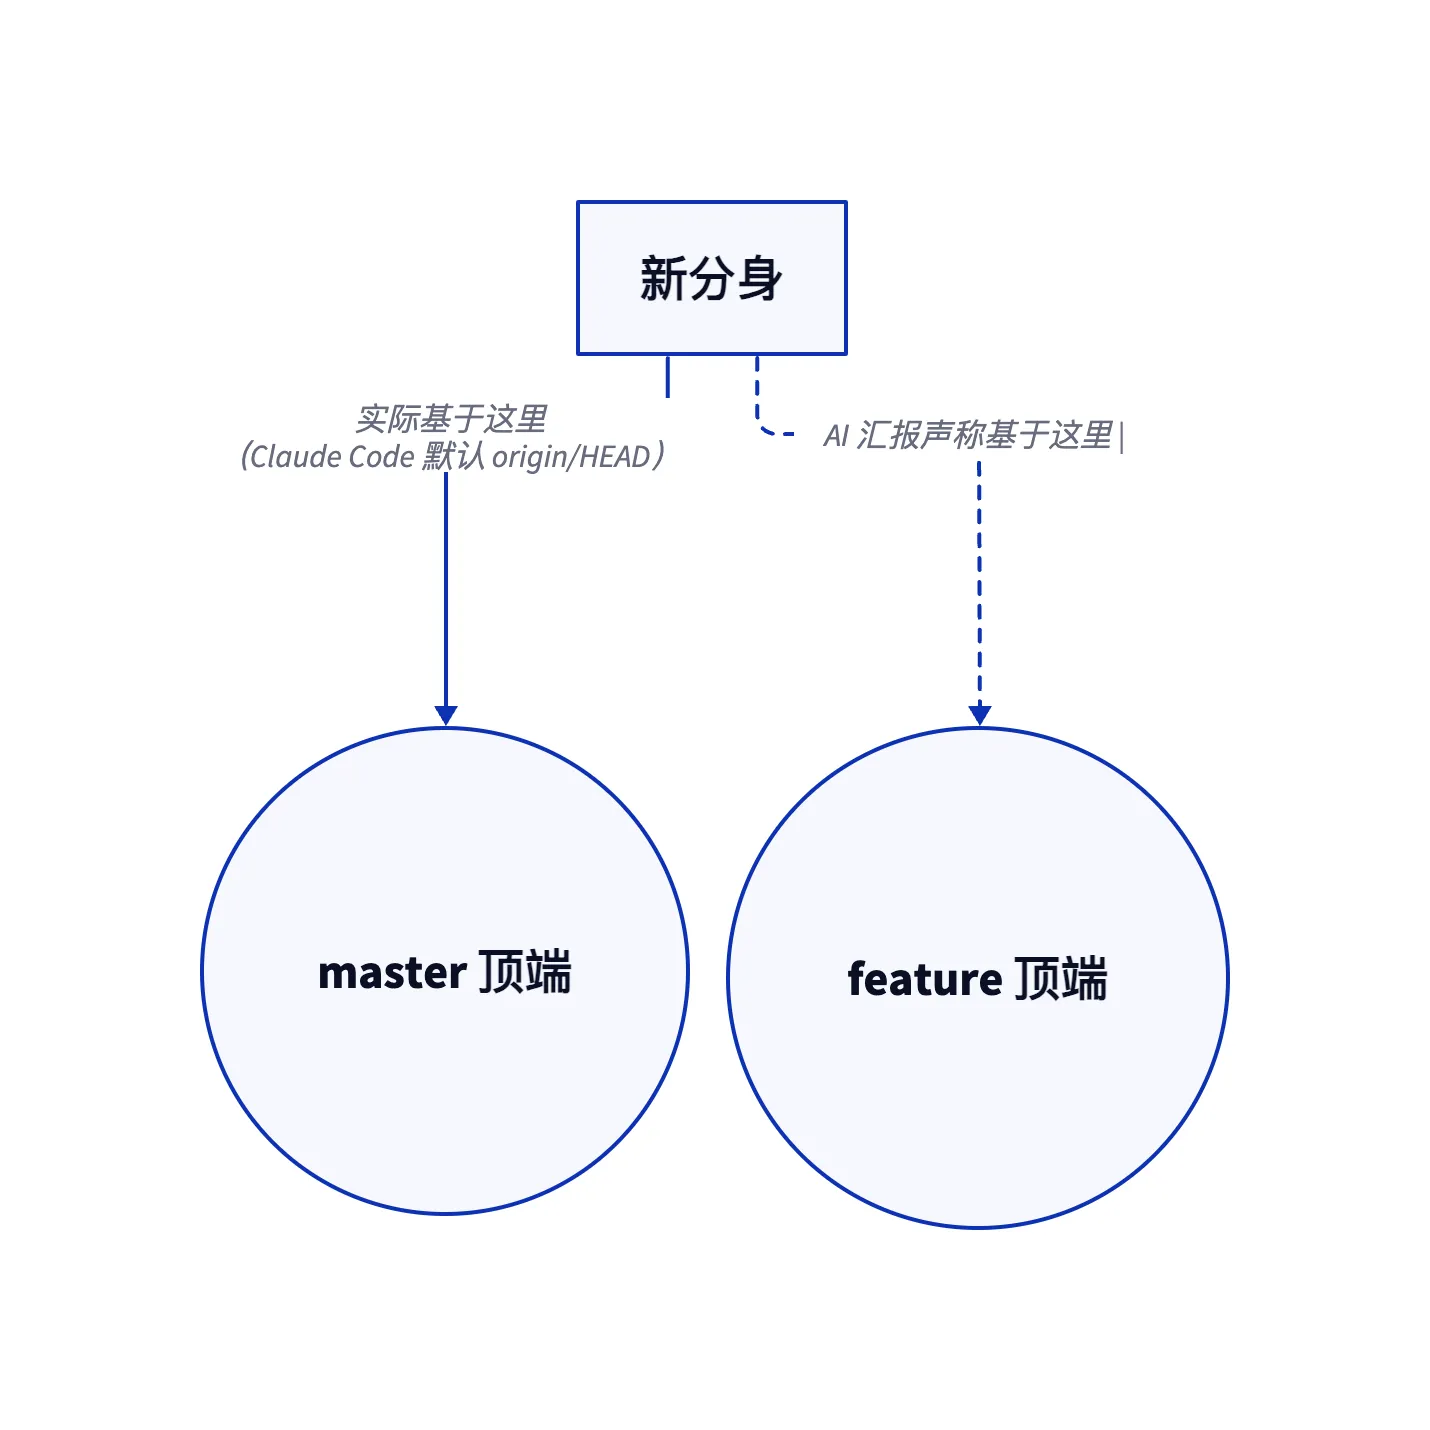
顺带一提:AI 建完汇报「已基于当前分支最新提交建好」时,别全信——Claude Code 的默认基准是 origin/HEAD(仓库默认分支),git 原生命令的默认基准才是当前 HEAD。到新目录跑一句 git log --oneline -1 验一眼再放行,我就实际抓到过汇报和事实不符的一次:
这只是开工时的一个验证动作,不算关卡。真正的关卡有两道,都在「分身能干活」这件事上。
第一关:分身会「失忆」
新 worktree 是一次干净的检出——被 .gitignore 的东西,全都不在。而我的项目把任务方案文档(dev-doc/、doc/)、AI 的项目规范(.claude/、.agents/,含构建说明、二十来条编码规则、术语表)全部 gitignore 了。也就是说,AI 一进新 worktree,两眼一抹黑:不知道怎么编译、不知道术语、手里连任务方案都没有。
AI 时代用 worktree,迁移成本的大头往往不是 node_modules,而是这些不上库的「AI 上下文」。老教程只会教你复制 .env、重装依赖,没人告诉你 CLAUDE.md 和任务文档才是新工作区的命根子:
# 手动建的话,把 gitignore 掉的 AI 上下文带过去(每个 worktree 一份)
cp -R dev-doc doc .claude .agents .mcp.json ../myproject-formula/
用 Claude Code 的话这一步可以自动化:仓库根目录放一个 .worktreeinclude,写上 dev-doc/、.claude/,它建 worktree 时会自动复制。
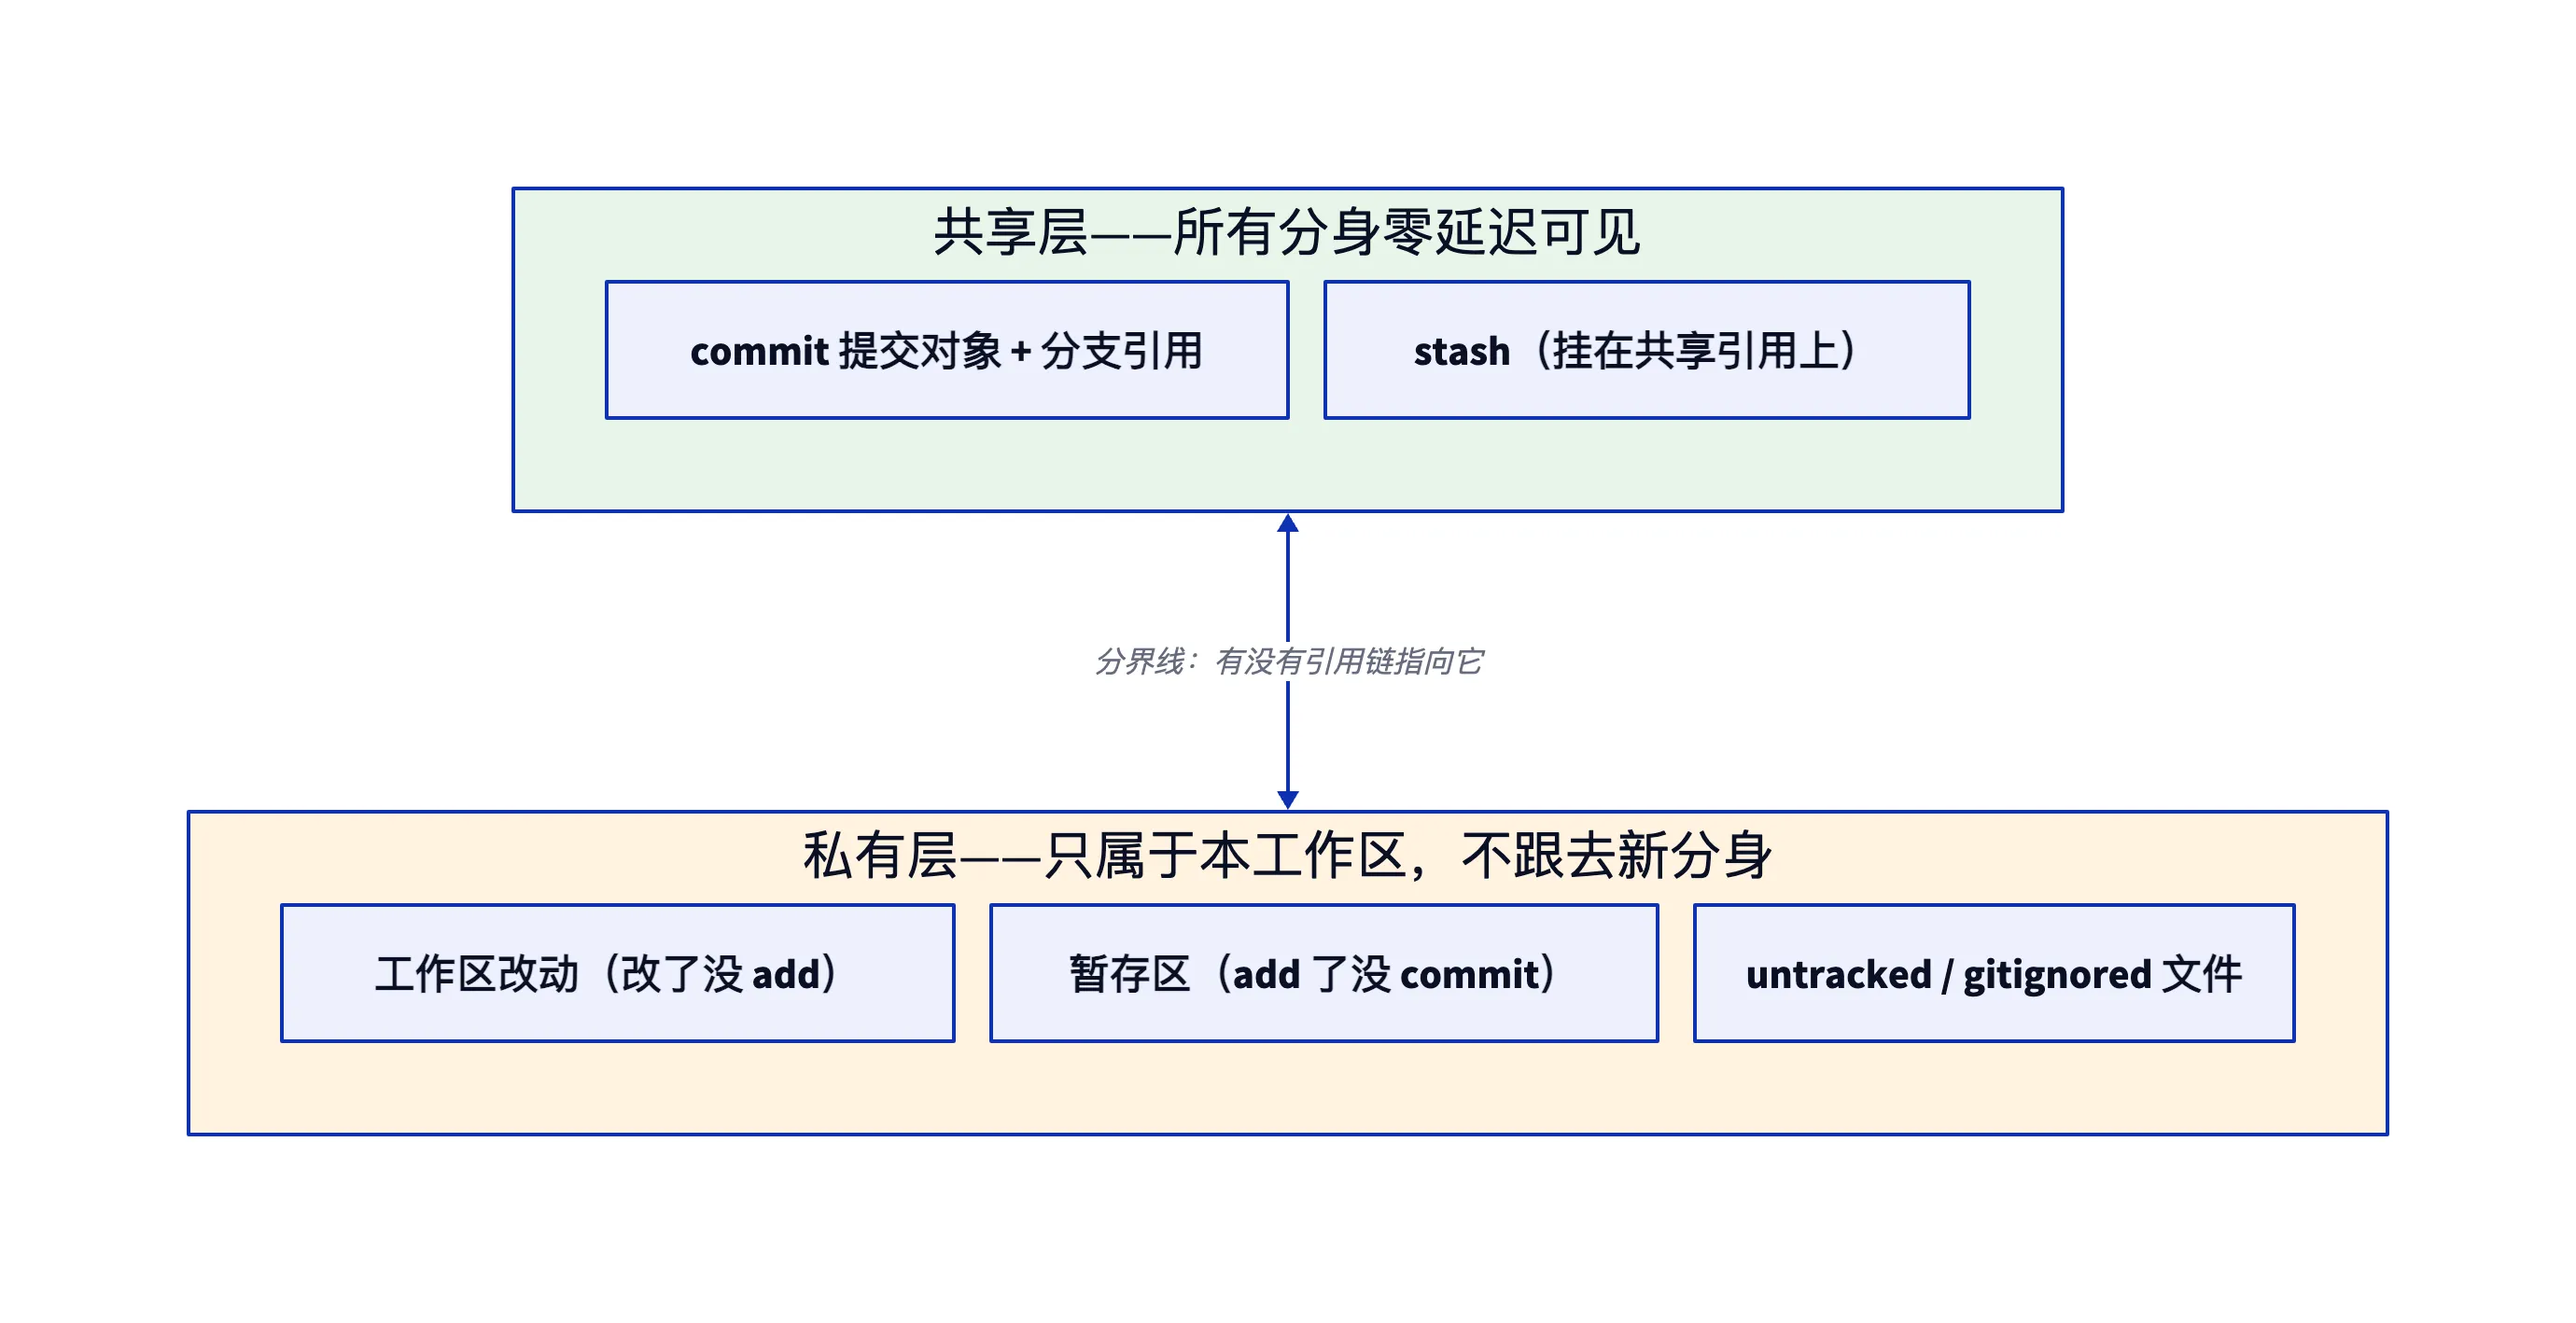
这里藏着 worktree 最核心的一条分界线,值得单独讲透——已提交的,所有分身瞬间共享;未提交的,一样都不会跟过去。
- 工作区改动(改了没 add):不带——只存在于那个目录的文件里;
- 暂存区(add 了没 commit):不带——每个 worktree 有自己独立的 index 文件;
- untracked / gitignored 文件:不带;
- 例外是 stash:它存在共享引用里,任何 worktree 都取得出来。
因为 worktree add 只认 commit:它从对象库把目标提交的快照原样铺进新目录,从头到尾不读别的 worktree 的任何状态。
更深一层看,「共不共享」的判定标准其实不是数据存在哪,而是有没有引用链指向它。git add 的那一刻,文件内容就已经写进共享对象库了——但唯一的指针是本 worktree 私有的 index 条目,别的分身够不着,没有 commit 指向它,迟早被垃圾回收。commit 和 stash 之所以能共享,是因为它们都创建了对象并挂在引用上(stash 本质是挂在共享引用上的一串 commit)。想把半成品带去新 worktree,三条正路:任务分支上先提个 WIP commit 回头整理、stash、或者导 patch。
第二关:测试跑不起来,凶手是缓存
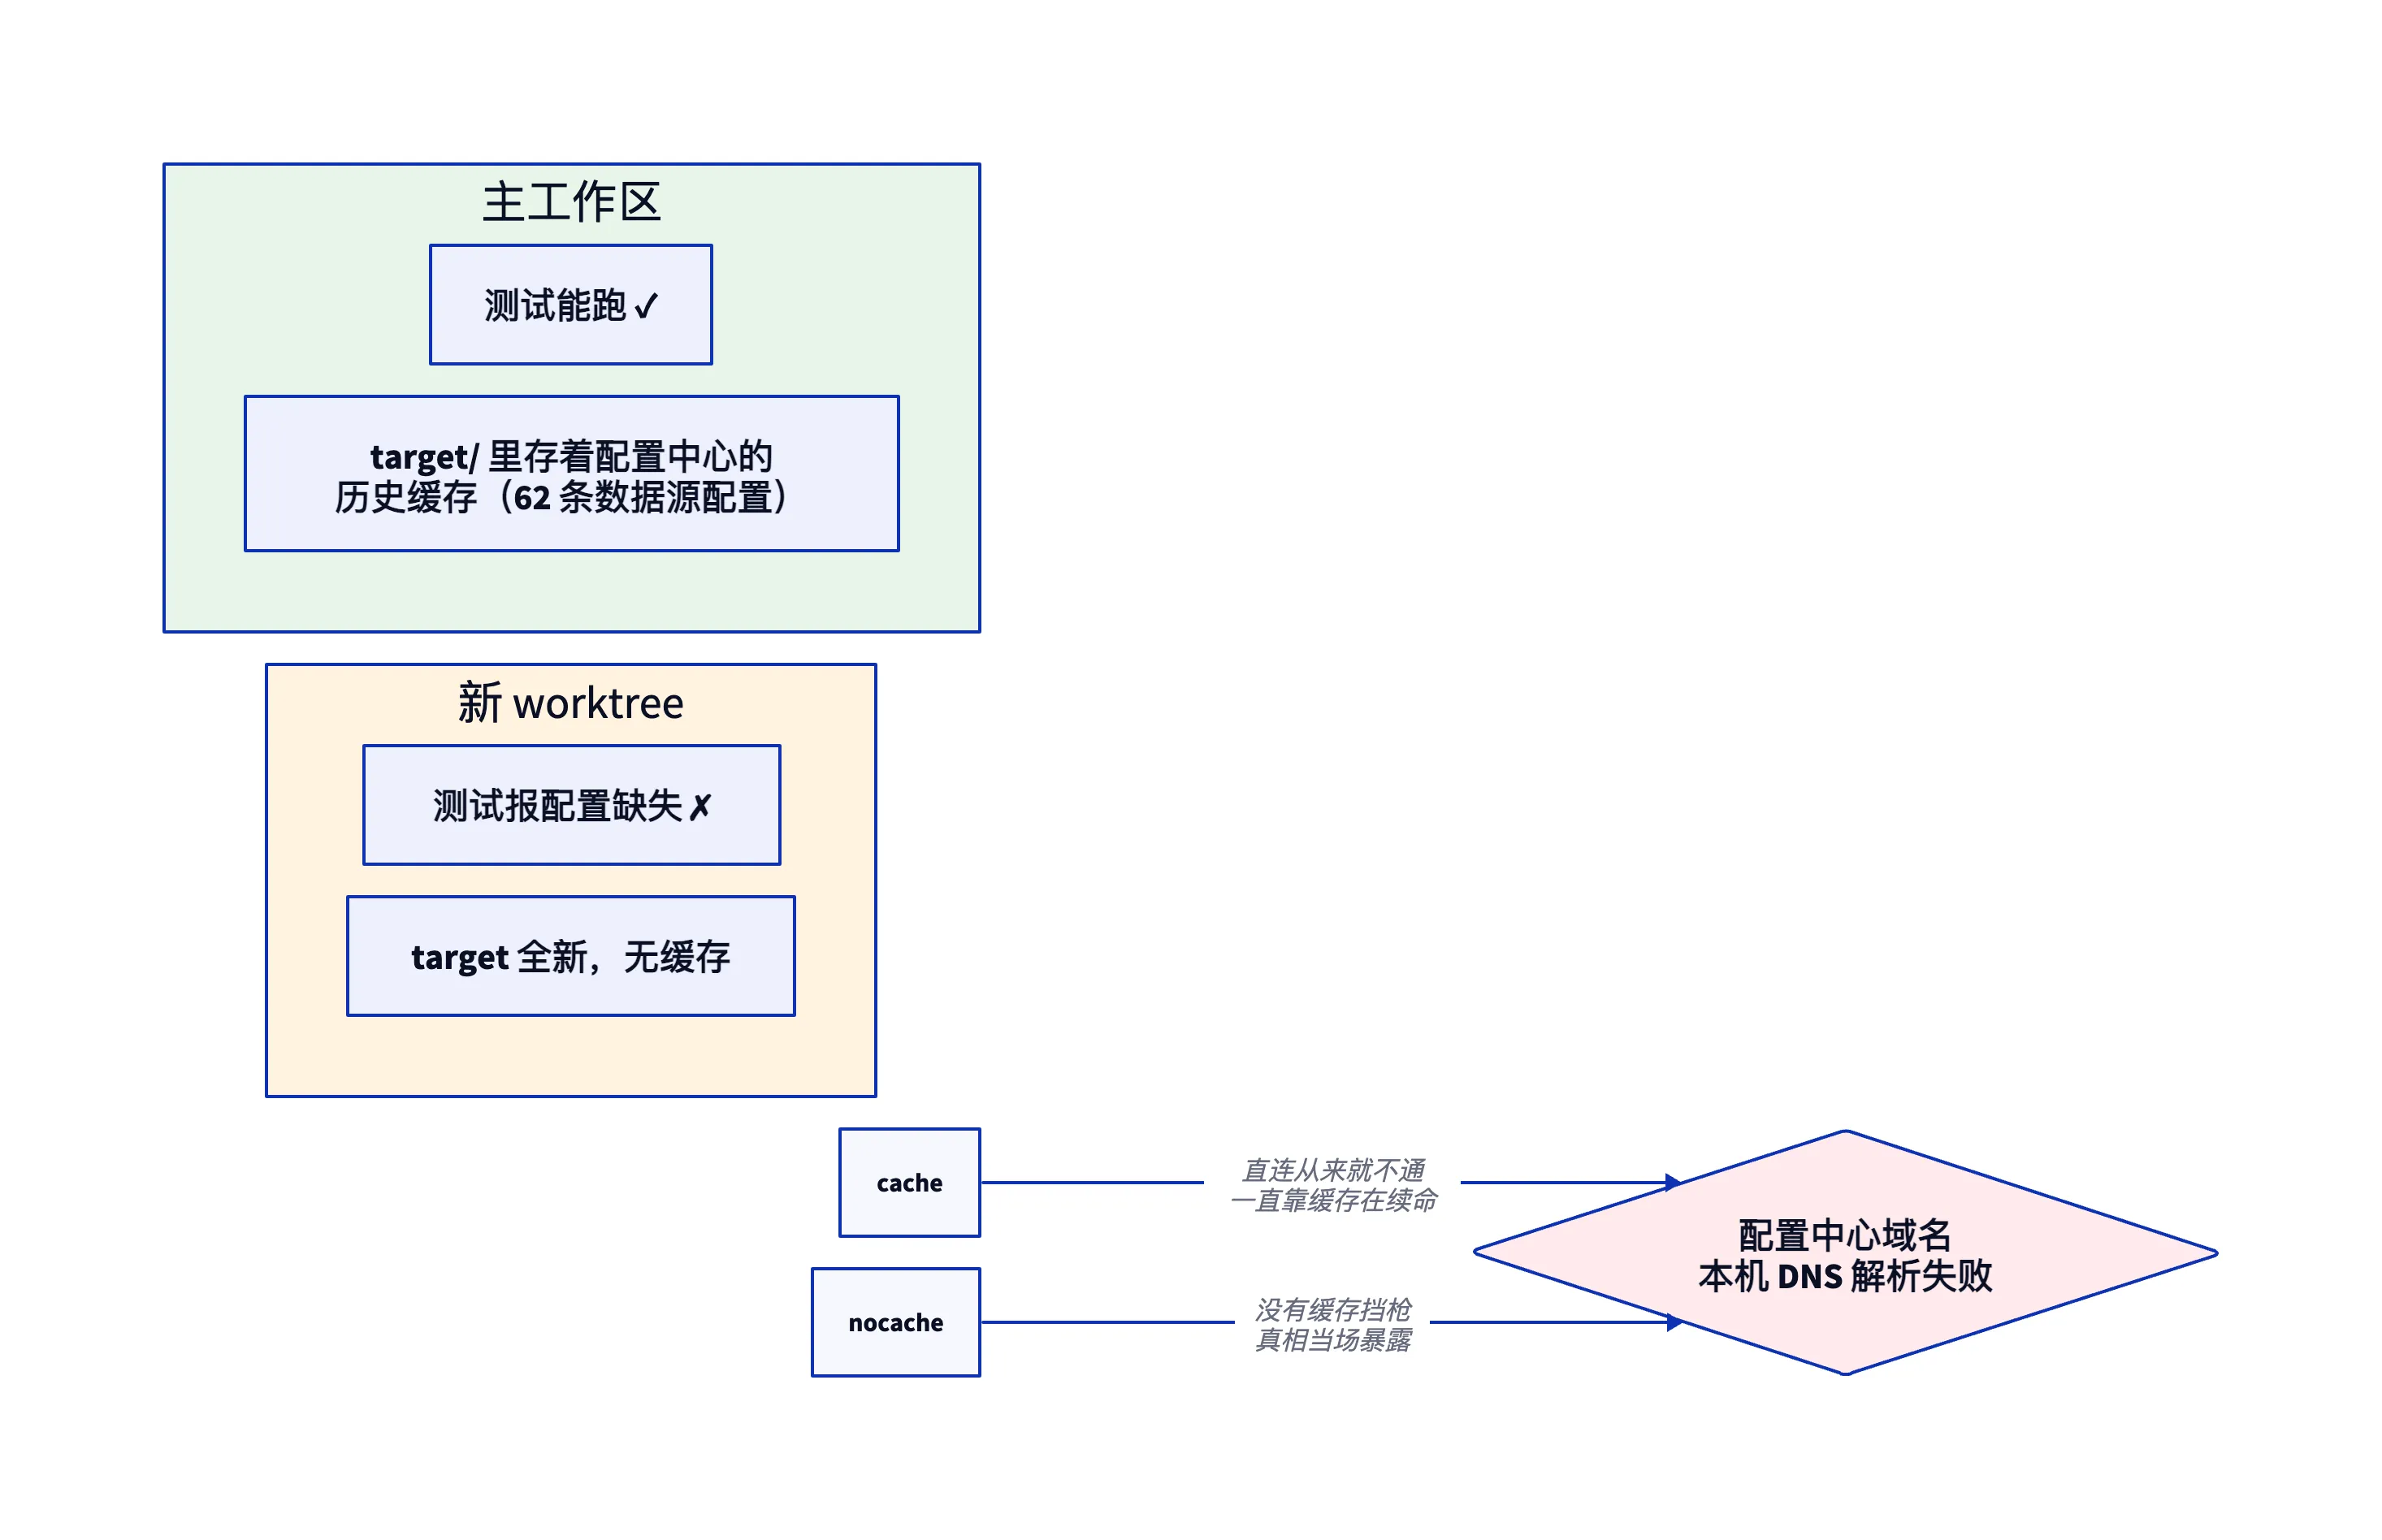
上下文就位了,真正的深坑在跑单测时现身:同一时段,主工作区测试能跑,新 worktree 报配置缺失。
先撞的是参数。单测的 JVM 参数(app.id、环境标识、密钥)常年躺在主工作区 pom 的本地魔改里,不会跟过去,测试连不上公司环境。会话们各自挣扎出三条野路子:
- 从 IDEA 运行配置的 XML 里把参数挖出来用;
- 按项目文档在命令行传
-DargLine,参数不落盘; - 以及一次把密钥明文写上命令行——反面教材,密钥从此活在会话日志里。
最后收敛成正经解法:参数进文档、规则进 AI 记忆,下个 worktree 冷启动即得——上下文工程做对了,人才真的可以什么都不懂。(这类被跟踪文件的本地改动,git 还有个 skip-worktree 开关能让它从 git 视线里消失,进阶用法。)
再深挖,真凶是缓存:配置中心域名在这台机器上 DNS 根本解析不了——主工作区一直靠构建产物里的历史缓存在续命,新 worktree 没有缓存,真相才暴露。你以为的「能跑」和真实的「为什么能跑」,中间隔着一个缓存。
合流:三条线收一条
三线各自开发、测试全绿之后,收尾是水到渠成的:每个分身各自提交(提交全部落在共享仓库里,主工作区零延迟可见),然后合流——推任务分支走 MR 是正式路线;快路线是在主工作区把两个任务分支依次 merge 进主线(三线文件零交集,合并干净),推远端:
git switch feature-V4.0.0         # 主工作区回到主线
git merge feature-V4.0.0-formula
git merge feature-V4.0.0-cashflow
这套命令在主工作区敲就行——merge 消费的是提交,不是目录:分身目录还在不在、在哪,都不影响合并,提交在,一切就在。这也反过来解释了为什么分身里的活必须先 commit:未提交的改动,merge 根本不认。
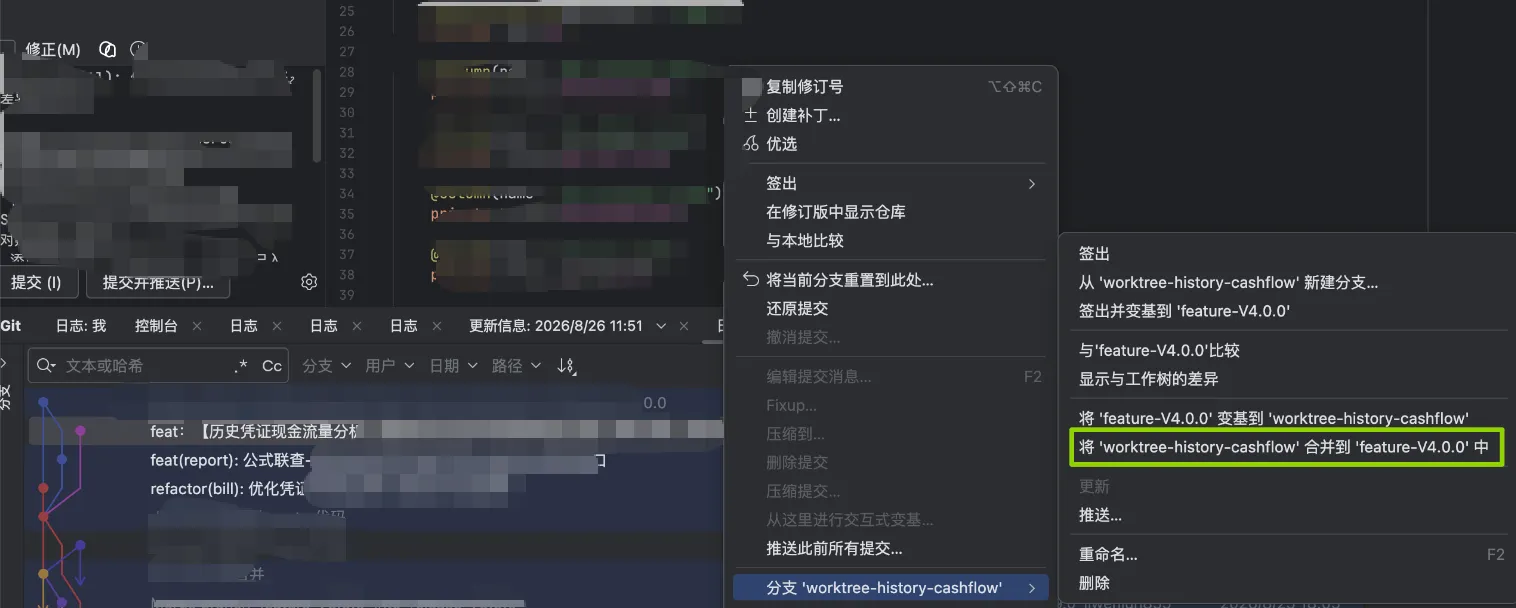
不敲命令也行,这是同一条路的 GUI 版:IDEA 用户打开 Git 日志视图,找到任务分支最新的提交,右键 → 底部的「分支 xxx」→「将 xxx 合并到 feature-V4.0.0 中」,点两下鼠标。我这次的三线合流,最后就是在界面上点完的:
用完的 worktree 是消耗品:git worktree remove 拆目录、git branch -d 删已合并分支;用 Claude Code 的话,退出会话时它检测到无未提交改动、无新提交,会提示自动清理。
多线并行还有几处会互相踩脚,提前知道就能避开。本地仓库 ~/.m2 是所有 worktree 共享的,一边 install 的 jar 可能被另一边的构建悄悄覆盖,所以构建别 install、带上 -am;测试库也是共享的,你会看到对方会话造的数据,造数时用动态前缀编码加事务回滚就互不干扰;还有,两边的 JVM 如果用相同的路由 tag,会抢端口,错峰起服务就行。
第三幕·沉淀:速查与清醒
坑速查表
| 坑 | 一句话解法 |
|---|---|
| worktree 目录嵌在仓库里还提交了 | 放仓库外,或先 gitignore |
| rm -rf 删了目录,git 还认 | git worktree remove;已 rm 的跑 prune |
| 构建产物每个分身一份 | 接受 ×N,或错峰构建 |
| 同分支互斥报 already used | 保护不是 bug,给分身独立分支 |
| 被跟踪文件的本地魔改 | skip-worktree + patch 重放;正解是搬进 untracked 文件 |
| 新分身连不上测试环境 | 参数走命令行,环境依赖查缓存 |
| 想双开又怕冲突 | 先确认文件级零交集;merge 的冲突它不包 |
清醒点:并行不是免费的
worktree 解决的是「同时开工」,解决不了「同时完工」。
三线并行意味着三倍 review 负担、三份合并风险、三倍上下文切换。AI 写得再快,瓶颈最后还是坐在屏幕前拍板的你。任务之间有依赖、改动面重叠大、或者一个人根本 review 不过来的时候,老实排队串行,比开三个分身更专业。
工具也一样:Claude Code 原生的 --worktree 已经覆盖最常见场景,先用原生的;worktree 多到需要看板管理了,再去看 Worktrunk、Conductor 这些工具不迟。
一句话收束:一个 .git 可以挂 N 个工作区,各自 HEAD、各自分支、各自提交;它买来的是过程隔离,买不来免冲突。 一个等了十一年的老功能,终于等到能把它用出花样的时代。
延伸阅读:上一篇《探针 1|为什么你每次问大模型,答案都不一样》 https://mp.weixin.qq.com/s/72whbs2w_Afrt-TUJrwOWg