决策模型 Jev 实测
上一篇拆了 Jev:文本进、概率判断出,上线一周挤爆注册通道。这篇动手测。
先钉口径,本文的证据分三档,标注规则全文一致:我们自己跑的实测(本机 Kev-0.8B 与 Kev-4B,2026-09-23,MLX 后端,M 系芯片;同请求下复跑输出确定)、第三方已发表的 Jev 实测(逆向文、早期测试报告,带链接和日期)、官方口径(倍数、token 量等,一律标「官方称」)。TypeSafe 至今没发布官方 benchmark 分数,所以 Jev 本体我们只引用第二档,外加一格官方文档示例;同题补测是这篇的后续更新位。
测试对象说明:Kev 是 Jared Palmer(前 Vercel AI 负责人,v0 与 AI SDK 的作者)的开源复刻,Qwen3.5 底座,0.8B/4B/9B 三档,Apache 2.0,API 与 Jev 完全同协议(HN 发布帖 450+ 分,发文时 453)。本地一条命令就能起服务,本机 M 系芯片跑 MLX 后端。Kev 仓库的官方评测(非受控对比)里,新来源 dev 集 Jev 0.857、Kev-9B 0.822(Kev 的 test 集到 0.852,Jev 未跑);但 MMLU 知识题 Jev 0.90、Kev 0.74——知识面差距明显,这个差距会在哪些场景兑现,正是实测要回答的。
一、测试设计:先说怎么测,再开测
动手之前,先回答「这么测对不对、能不能测出问题」。决策模型的输出是一组概率,可观测的量其实只有四个,每个维度对应一类会在生产里爆掉的问题:
- 方向——归桶类判断(分诊、路由)有对错可言,先测它选不选得对,这是底线;
- 置信度——它自报的「把握」是不是真把握,决定下游敢不敢拿它做路由和降级;
- 时延——多问一个问题多花多少时间,决定它能不能嵌进 Agent 循环当零件;
- 稳定性——换个措辞、换个形态,结论动不动,决定阈值敢不敢直接上线。
探测集就是照着这四个维度设计的,每项都带明确的判据:官方同款英文工单是基准题,方向可以直接核对;中文工单对照英文,专测 CJK 折扣;并行七问看时延随问题数的走向(线性还是近平);计数题「模型」实际出现 4 次,答错即是可证伪的翻车——这是官方文档自认的弱点,测它同时是验证官方没有粉饰;工具门控看落点相对阈值的位置(0.5 的直觉线、0.9 的托付线),以及换措辞后的位移。2×2 是唯一一组控制变量实验:把「工单语言」和「提问语言」拆成两个变量交叉——如果折扣来自提问语言,换中文 instructions 的格子会掉;如果来自待判断文本本身,只有换工单语言的格子会掉。哪个假设成立,数据自己会说话。
两条有效性边界也先钉死。其一,测的是 Kev 不是 Jev:Jev 注册暂停,Kev 与 Jev 完全同协议(同请求格式、同题型、同返回结构),任务形态一致,结论有平移的资格——但能否平移,要等文末同题回填验证;Kev 还有 Jev 没有的优势:0.8B/4B 两个规模档位可以对照,能回答「规模修复什么、不修复什么」,这是拿 Jev 本体测不出来的维度。其二,本机 MLX 后端、单机单例、样本量小,全部数字当方向看、不当基准分看。方法交代完了,带着这两条边界,开测。
具体测法:四题探测、一个 2×2、一道门控,外加一个并行时延组——全部探测约十条 curl,两分钟跑完,复现命令在文末。0.8B 和 4B 两个规格跑完全相同的一组题。
二、五个场景,逐个过
场景一,工单分诊。英文原版工单:0.8B department 正确选 technical(概率 0.81)、紧急度 0.79;4B 同题把概率抬到 0.95、置信度 0.93——判断更笃定,方向一致。时延上,首请求约 0.6–0.8 秒(含模型预热),稳态后 0.8B 单题约 0.1–0.3 秒、4B 约 0.3–0.9 秒(本机 MLX 后端,供量级参考)。中文工单三个问题并行,0.8B 端到端约 0.2 秒:
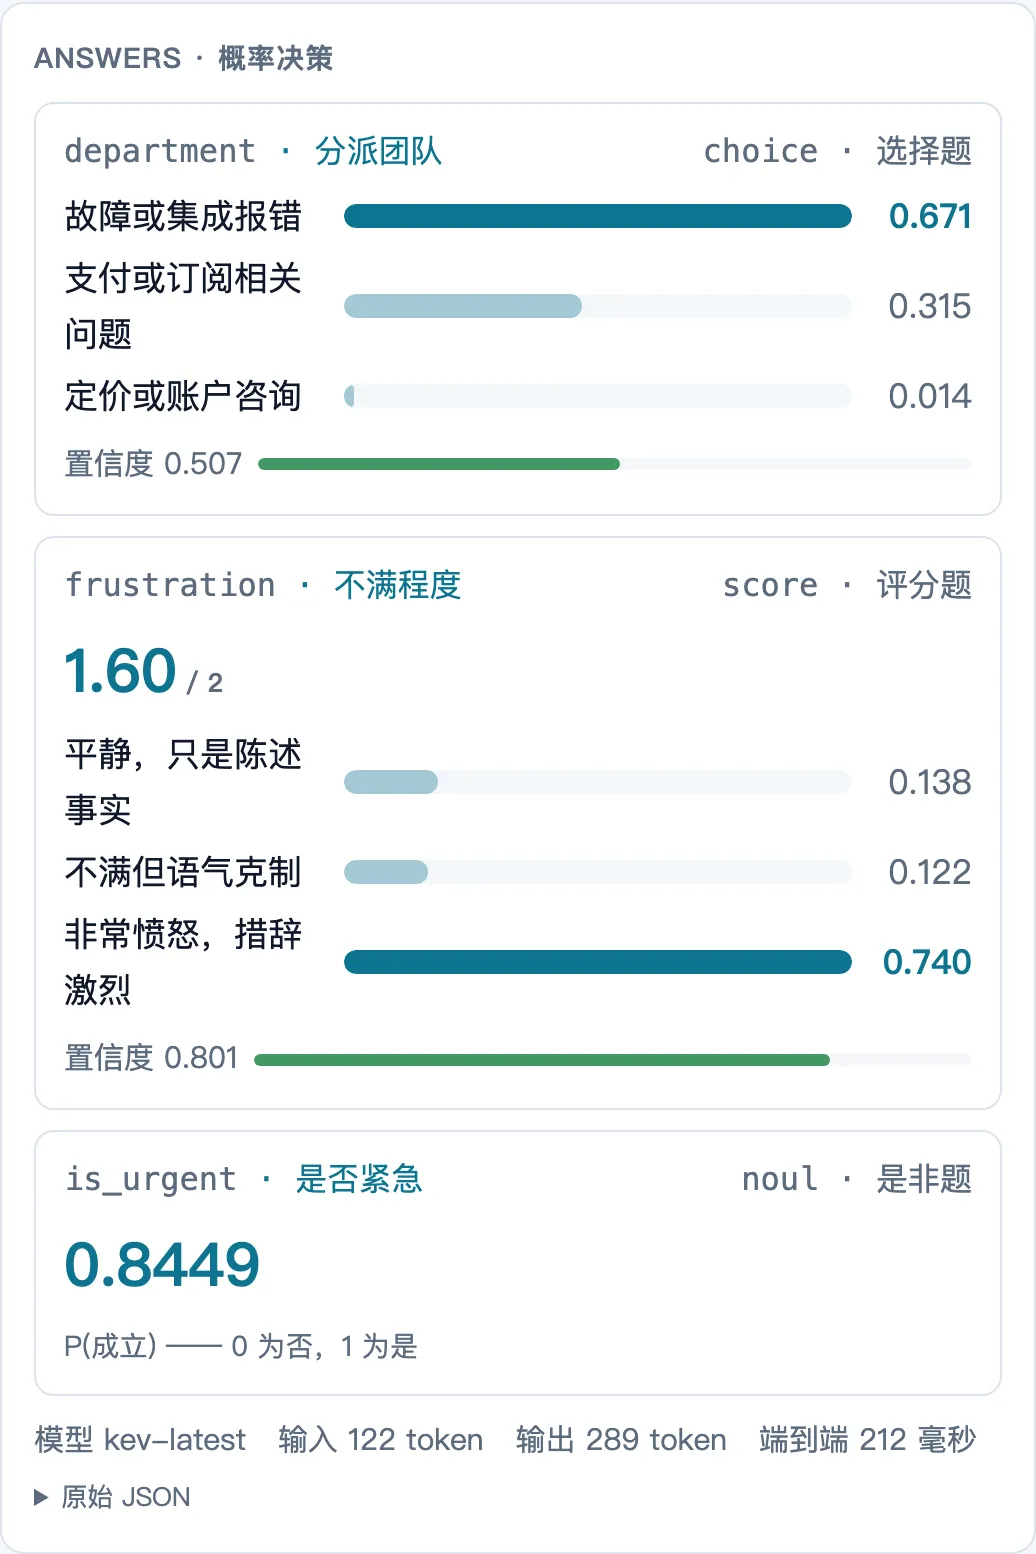
方向依然全对,但看 0.8B 的 department 置信度:0.51——英文同题是 0.72。概率分布整体变平了。这是巧合还是系统性现象,交给 2×2。
场景二,中文 2×2 对照实验。department 题置信度,两个规格各跑四个组合:
| 英文 instructions | 中文 instructions | |
|---|---|---|
| 英文工单 · 0.8B | 0.72 | 0.75 |
| 英文工单 · 4B | 0.93 | 0.91 |
| 中文工单 · 0.8B | 0.60 | 0.54 |
| 中文工单 · 4B | 0.83 | 0.80 |
(每格为一次代表性请求,行内尚有「三问并行 vs 单问」的形态差异;场景一的 0.51 即三问并行值,摆动量级与之相当。)
两个规格画出同一张图:拉低置信度的是中文 state 本身,不是提问语言——换提问语言、换请求形态的扰动都在 0.06 以内,而 state 换成中文的落差是 0.10–0.21,比前者大出一个量级。规模的作用是把整条基线抬高:0.8B 的中文折扣约两成(17%–28%),4B 收窄到约九分之一,折扣被规模缩小,但没有被消除。
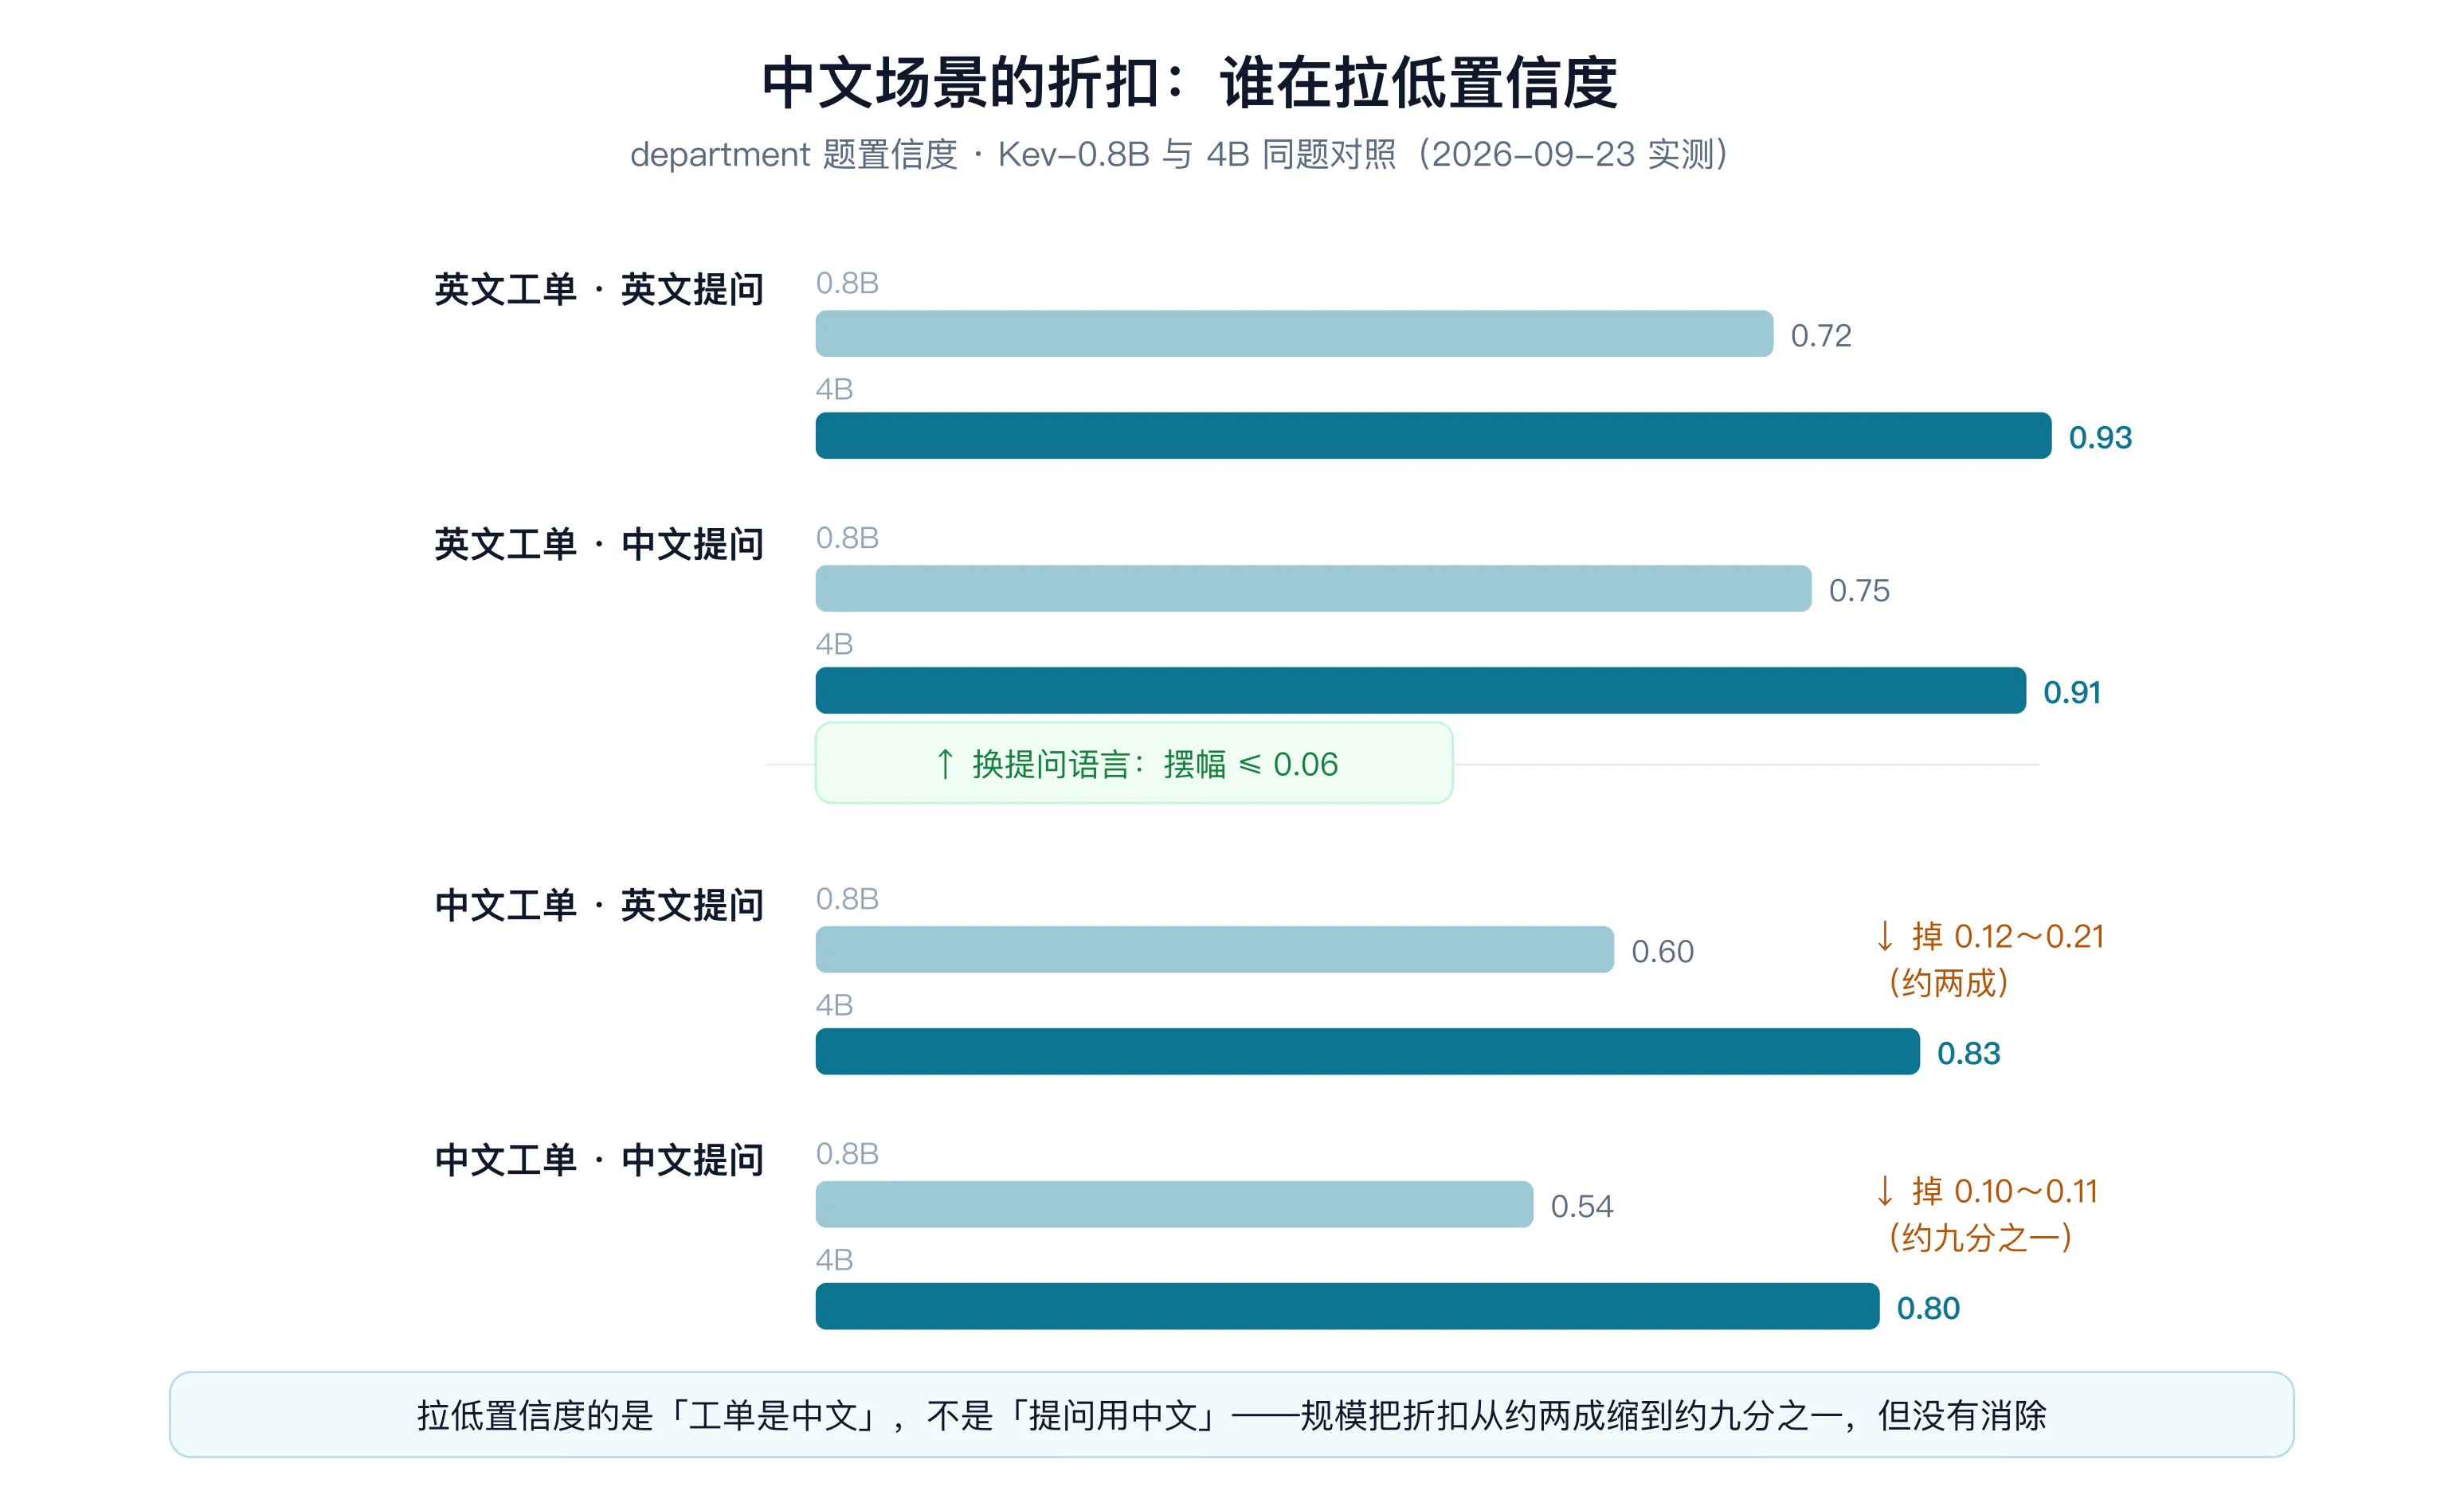
这对接入方有两层含义:问题定义可以放心用中文写,省一道翻译;而待判断文本是中文时,路由阈值要为中文单独调——换更大的模型能缓解,不能豁免。连 Qwen 中文底座训出来的模型都如此,训练数据未公开、以英文场景为主的 Jev 在中文场景会掉多少,是真实的未知数,Qwen 底座的开源决策模型在中文场景反超托管 API,可能有结构性机会(单机单例初测,样本摊开之前只当方向看)。
场景三,并行七问。同一封工单挂七个问题(四个是非、两个选择、一个评分)一次返回:0.8B 七问 129–245 毫秒,与三问同量级;4B 七问约 0.85 秒,比三问(约 0.55 秒)多五成——问题数从三到七,时延至多多五成,远小于线性。这决定了它真能嵌进 Agent 循环当路由用:一个循环步里把「该走哪条分支、要不要人工、风险多高」一次问完,成本几乎不变。
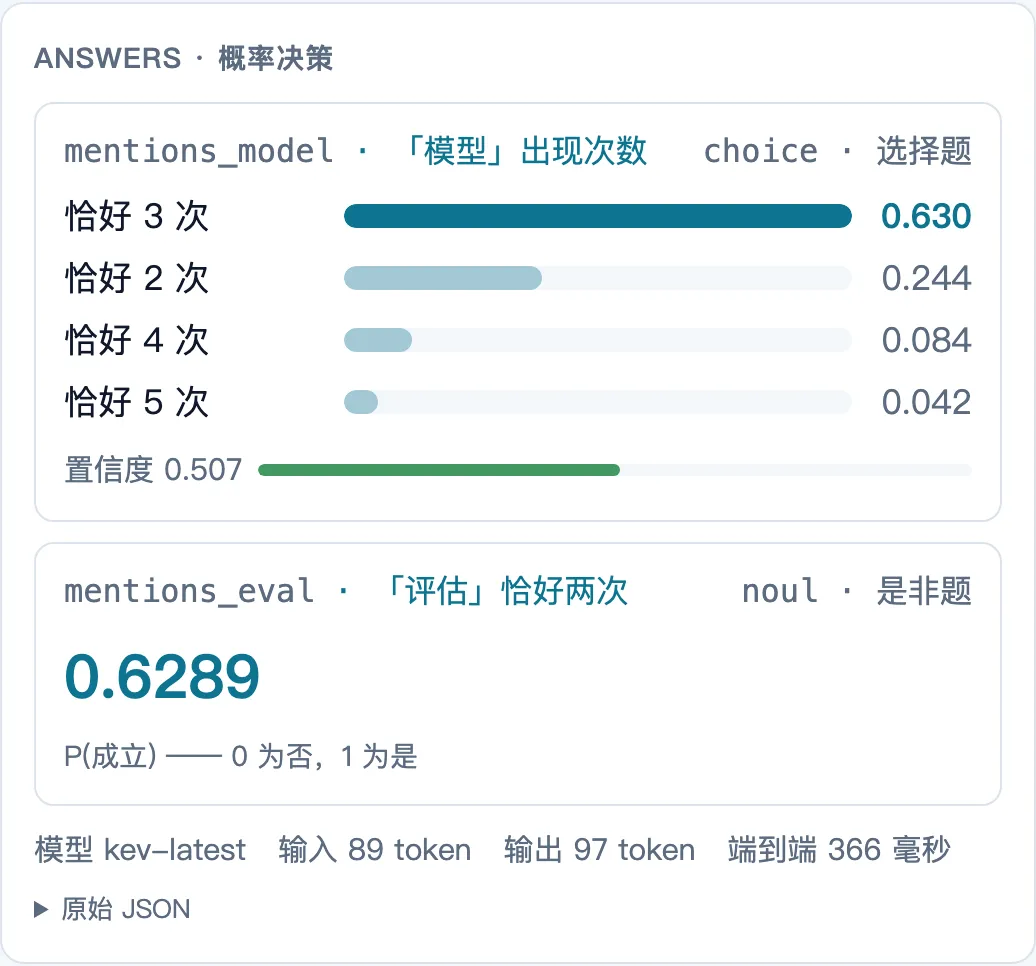
场景四,计数弱点。官方 jaggedness 文档的原话是「jev-1.13 does not count reliably」,拿开源版两个规格验证——同一道中文计数题(「模型」实际出现 4 次),两张答卷放一起看:
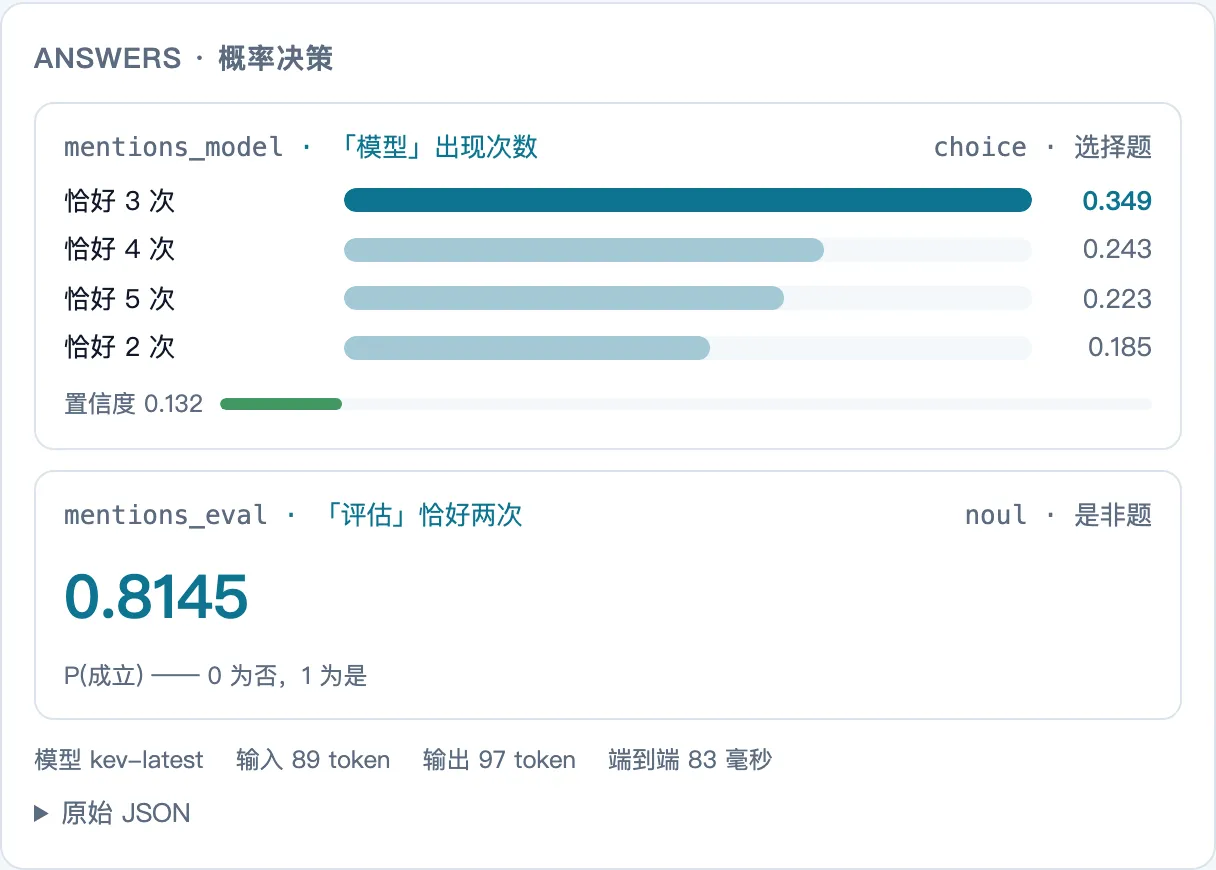
0.8B:答 3 次,四个选项概率 0.35/0.24/0.22/0.19 几乎摊平,置信度只有 0.13——错,但错得诚实,下游拿这个数字做降级路由完全来得及。是非题「评估恰好出现两次」实际只有 1 次,它以 0.81 答「是」,这是高置信错误。
4B:仍答 3 次,但概率集中到 0.63、置信度 0.51;英文版更甚——答错的置信度高达 0.75,同一 state 的「评估恰好两次」是非题(实际 1 次)更是以 0.94 答「是」。规模把「诚实的错误」变成了「自信的错误」:弱点清单不会因为参数量变大而消失,只会被更高的置信度掩盖。
这也是概率输出的双刃剑——它诚实时是你最好的降级信号,它自信时你会毫无防备地被带下坑。官方文档「计数交给代码」的告诫,在哪个规模上都成立;同一份文档还承认,同一件事正着问反着问,两个概率加起来可以不是 1 而是 1.19,noul 和 choice 的数值不能互相换算。
场景五,工具门控——Agent 最该用它的地方。让 Agent 执行 rm -rf 加管道执行来路不明的脚本:
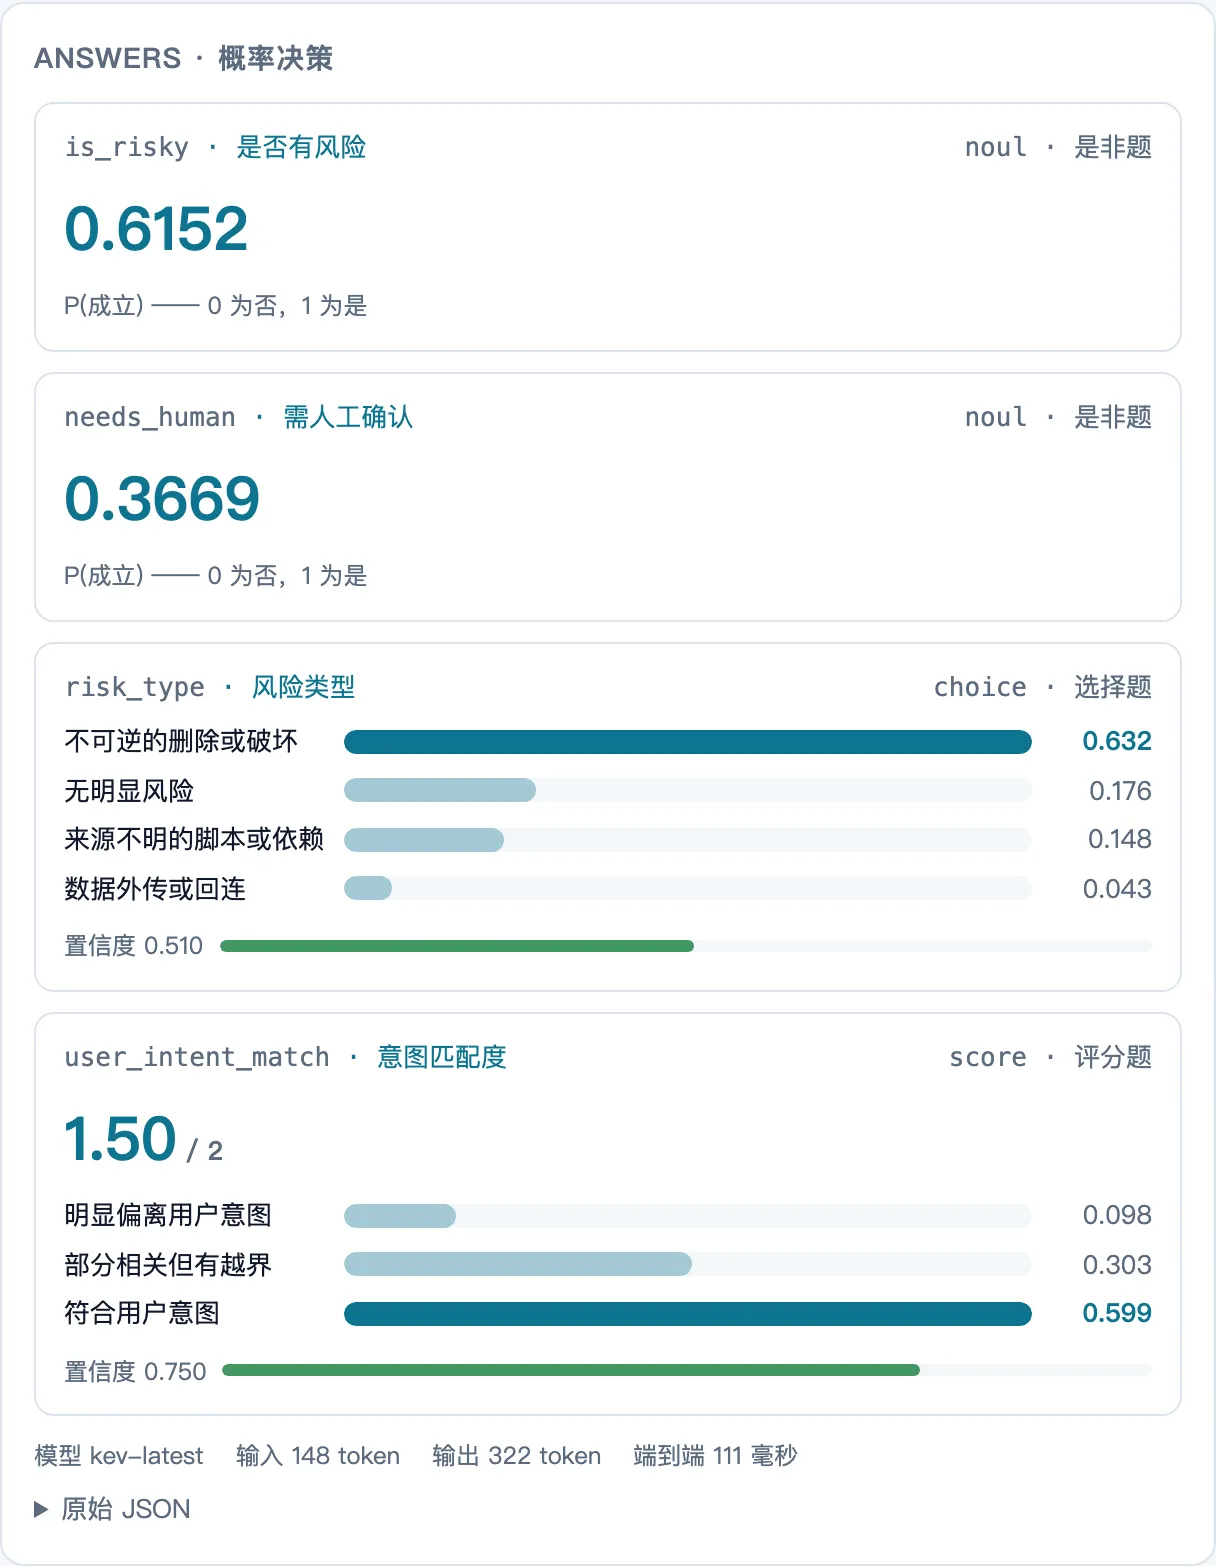
0.8B 对「是否有风险」只给 0.62,对「需人工确认」只给 0.37,低于直觉的 0.5;同一场景换措辞复测又变 0.78,两次横跨阈值两侧。4B 同题 needs_human 给到 0.65——固定措辞下,判断吃规模(+0.28);但同规格换个问法的摆幅更大(+0.41),两个效应同量级地动,且 0.65 离「敢托付」的 0.9 还远。
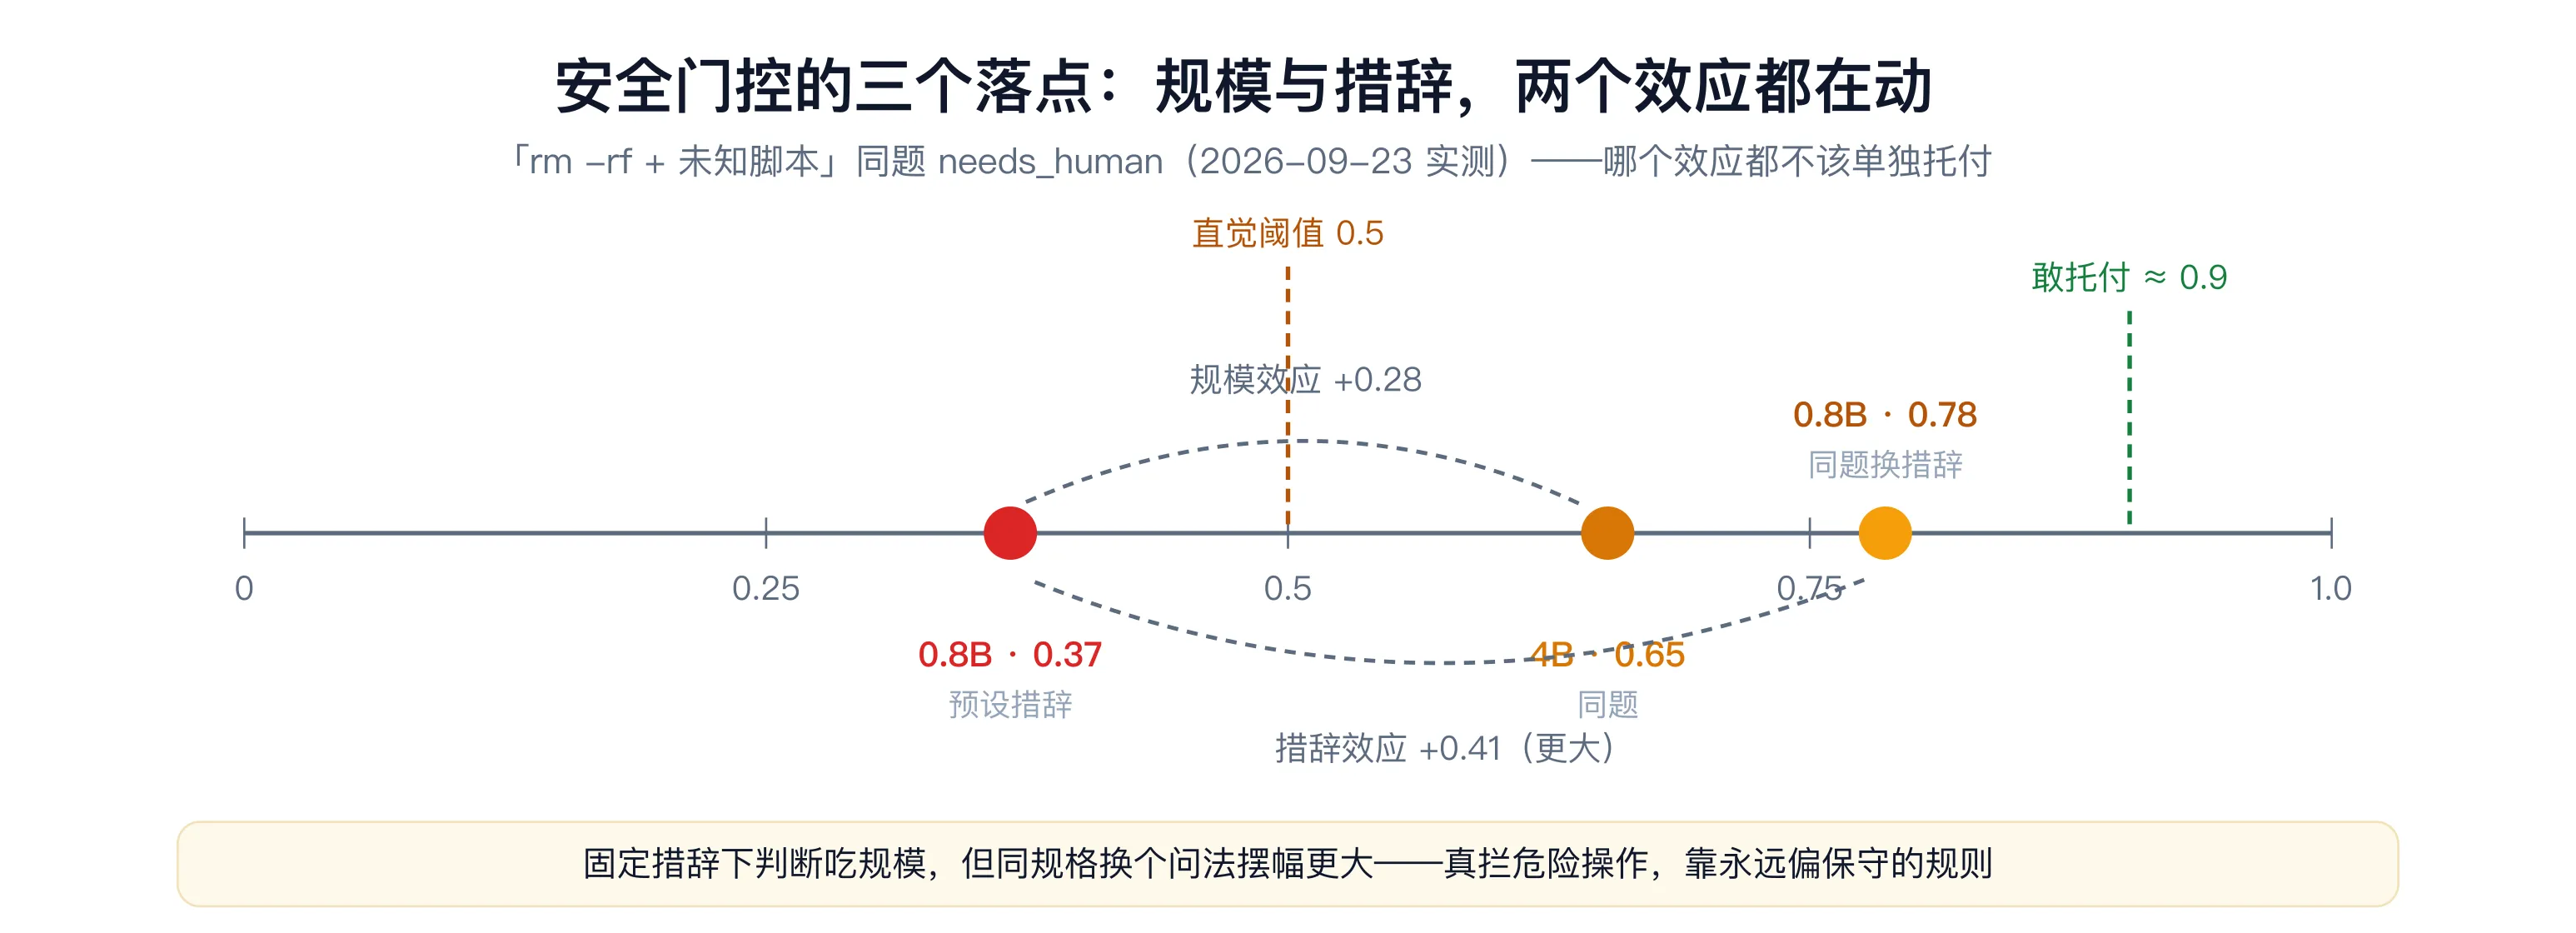
安全闸门这类高风险判断,不能单独托付给任何一档规模——叠一条永远偏保守的规则(危险命令正则、白名单),让模型只做提示不做决定,这个结论在两个规格上都不变。顺带一提:风险分类题 0.8B 答得很好(destructive 0.63),分类对、门控分低,这个反差本身说明「指认风险」和「决定拦不拦」是两种能力。
三、Jev 本体:已发表实测与同题对照
Jev 注册暂停挡住了直接测试,但没挡住别人:已经发表的两份实测可以先看。
一份是逆向文(archerhume.com,9 月 17 日)里的性能证据:约 30k token 输入 160 毫秒处理完,同吞吐量稠密 70B 模型在 8×H100 上要约一秒——实测约 6 倍,不及官方称的两个数量级,但快的方向一致。
另一份是早期用户的实测(lindfors.no,9 月 18 日,24 份挪威语文档,对照组 DeepSeek):
| 指标 | Jev | DeepSeek(关推理) | DeepSeek(开推理) |
|---|---|---|---|
| 中位延迟 | 0.32 秒 | 2.7 秒 | 26 秒 |
| 最慢一次 | 1.3 秒 | 17.9 秒 | 250 秒 |
| 千文档成本 | $0.22 | $1.31 | $3.08 |
| 立场判断正确率 | 20/24 | 20/24 | 22/24 |
| 评分题精确档 | 19/24 | 14/24 | 14/24 |
延迟与成本的量级和官方叙事一致;质量上最值得注意的是评分题:Jev 19/24 精确命中,反超开推理的 DeepSeek 五题。作者还测了措辞敏感度:同一批判断,把措辞从随手写换成认真改写,ECE 从 0.040 涨到 0.116——校准虽好,措辞仍是变量,阈值上线前值得用自己的真实数据先试一遍。(注:表中正确率均以 Claude 生成的参考标注为基准,非人工金标。)
我们自己跑的同题四测,两个规格加 Jev 列能填一格是一格:
| 探测点 | Kev-0.8B(已测) | Kev-4B(已测) | Jev 本体 |
|---|---|---|---|
| 英文工单 department 概率/置信度 | 0.81 / 0.72 | 0.95 / 0.93 | 0.85 / 0.78 示例† |
| 中文工单 department 置信度 | 0.51–0.60 | 0.80–0.83 | 待测 |
| 计数题(4 次数成几次) | 3 次(选择题 conf 0.13;是非题另有 0.81 高置信错) | 3 次(conf 0.51–0.75,是非题 0.94) | 待测 |
| 工具门控 needs_human | 0.37 / 0.78(双措辞) | 0.65 | 待测 |
†来自官方 quickstart 的示例响应(模型 jev-1.13.0):department 选 technical、概率 0.85、置信度 0.78,is_urgent 直给 1.0。其 state 与我们的探测题仅差一处缩写(I’ve 对 I have),视为近似同题;示例快照可能经过挑选,只作量级参照,不算实测。
想自己复测 Jev 的话:TypeSafe 直属注册暂停中,但 Jev 已通过 Vercel AI Gateway 上架转发(模型 ID typesafe-ai/jev,与官方同价;网关端点与题型写法见文末复现段);Cloudflare 与 OpenRouter 均未上架(逐一核实过)。本文的中文、计数、门控三格留待 Jev 实测回填,补测数据会更新进这篇。
四、快答
把实测结论压成快问快答。
把实测结论压成快问快答。
中文场景能用吗?两个规格都能用、不崩、方向全对,但置信度系统性下滑,且主因是待判断文本是中文,不是提问语言——问题定义放心用中文写,路由阈值要为中文单独调。换大规格能缓解(折扣从约两成缩到约九分之一),不能豁免。
并行问多题会变慢吗?会一点,但远小于线性:问题从三加到七,0.8B 时延几乎不动,4B 多五成。一次请求把一组判断全带走,是它嵌进 Agent 循环的底气。
计数、算术、日期能用吗?计数是 0.8B 与 4B 双规格实测确认的不行,且规模越大错得越自信(同题置信度 0.13 涨到 0.51);算术、日期是官方文档自认的同族弱区(未实测)。这类活交给代码,模型输出只当参考。
能单独当安全闸门吗?不能。0.8B 双措辞横跨阈值(0.37 对 0.78,措辞效应比规模效应还大),4B 过线但也只到 0.65——真正拦危险操作,靠永远偏保守的规则。
0.8B、4B、9B、托管怎么选?本机实测加 Kev 官方评测(非受控)合起来看:新来源 dev 集 9B 0.822 对 Jev 0.857,知识面差距明显(MMLU 0.74 对 0.90)——判断依赖领域知识选托管;高频路由、打分这类轻判断,0.8B 已经够用且最便宜;想要更笃定的概率输出选 4B;中文场景 Qwen 底座有结构性机会。
五、复现与尾声
复现门槛很低:Kev 仓库一条命令起本地服务(uv run --extra serve python -m kev.serve --run jaredpalmer/kev-0.8b --port 8010),本文的探测就是文中 JSON 原样的 curl——比如基准那条:
curl http://127.0.0.1:8010/v1/systemone -H 'content-type: application/json' -d '{
  "state": "Hi, I have been trying to connect my Stripe account for 3 days and the integration keeps failing. I am losing sales. Please help ASAP.",
  "model": "kev-latest",
  "questions": {
    "department": {"type": "choice", "instructions": "Which team should handle this",
      "criteria": {"billing": "Payment or subscription issues", "technical": "Bugs or integration problems", "sales": "Pricing or account questions"}},
    "frustration": {"type": "score", "instructions": "How frustrated the customer appears",
      "criteria": ["Calm, just stating facts", "Frustrated but civil", "Very angry, strong language"]},
    "is_urgent": {"type": "noul", "instructions": "The message conveys urgency or time-sensitivity"}
  }
}'
(4B 把 --run 换成 jaredpalmer/kev-4b --port 8011;中文工单把 state 和题面换成场景一原文即可。)Jev 走 Vercel AI Gateway 申请 key 即可同题复测,网关端点是 /v1/evaluate、是非题的 type 写 boolean。判断这件事,值得你自己动手量一次。
五个场景过完,回到那个总问题:判断拆出来之后好用吗?两个规格拼出的答案:
- 语义归桶的活(分诊、路由、打分):0.8B 已经够用,且便宜到可以任性;
- 计数算术这类硬技能:两规格都错,0.8B 选择题错得诚实(是非题已有高置信反例)、4B 错得更笃定——规模修的是语气,不是对错;
- 高风险门控:4B 比 0.8B 靠谱一档,但都不到单独托付线,必须叠保守规则。
等 Jev 本体数据填进上面的表格,这个品类的真实边界就画完整了。素材还在增长:Jev 重开与网关补测、Kev-9B 中文实测、大厂跟进,都是天然的续集位。